虚拟模型
虚拟模型把主模型、备用模型、Channel 排序策略、推理参数和系统提示词打包成一个名称。客户端把请求的 model 写成 @vmodel/<名称>,网关先调用主模型,失败时按顺序改用备用模型,并把参数和系统提示词合并进发给上游的请求。之后更换模型或调整参数,只需修改虚拟模型,客户端代码不用改。
适用场景
- 多个应用共用同一套模型和参数,需要集中调整。
- 主模型不可用时自动改用其他模型,客户端不必自己换模型重试。
- 统一并锁定
temperature、max_tokens、输出格式等参数。 - 为没有自带系统提示词的请求补上统一的系统提示词。
如果只需要在同一模型的多个通道之间选路,直接调用模型 ID 即可,见通道选择与路由策略。
调用虚拟模型
把 model 写成 @vmodel/<名称>,其他写法与调用普通模型相同。下例调用名为 support-bot 的虚拟模型,环境变量的设置见完成第一次模型调用:
curl "$LYROUTER_BASE_URL/v1/chat/completions" \
  -H "Authorization: Bearer $LYROUTER_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"model":"@vmodel/support-bot","messages":[{"role":"user","content":"用一句话介绍你自己"}]}'
- 支持的接口:
/v1/chat/completions、/v1/messages和/v1/responses。图像、视频和语音接口不支持虚拟模型,会返回 403Model is not available in the model plaza,请改用具体的模型 ID。 - 名称区分大小写:名称只含小写字母、数字和连字符,
@vmodel/Support-Bot找不到support-bot。旧前缀@preset/<名称>与@vmodel/<名称>等价。 - 按工作空间区分:虚拟模型属于一个工作空间,该工作空间的任何有效 API Key 都可以调用它,没有单独的 Key 级授权。
- 查询可用名称:
GET /v1/models会以@vmodel/<名称>列出工作空间中已启用的虚拟模型。看不到虚拟模型页面的成员可以从这里查到名称。 - 上游与计费:上游收到的
model是实际调用的模型 ID,费用也按实际模型计算。
创建虚拟模型
当前账号管理员在工作空间的 虚拟模型 页面点击 创建虚拟模型。普通成员看不到这个菜单,但可以调用已经启用的虚拟模型。表单分为「基础信息」「模型与路由」「推理参数」「系统提示词」四部分,只有「虚拟模型名称」和「默认模型」是必填项。
| 字段 | 说明 |
|---|---|
| 虚拟模型名称 | 调用名,即 @vmodel/ 后面的部分。只能用小写字母、数字和连字符,以字母或数字开头,在工作空间内唯一 |
| 默认模型 | 优先使用的模型,列表中显示为「主模型」 |
| 备用模型 | 可选,可填多个,主模型不可用时按填写顺序尝试 |
| Channel 排序策略 | 同一模型有多个通道时的排序:按价格优先、按吞吐量优先、按延迟优先、负载均衡(默认) |
| 推理参数 | 七组共 17 个参数,每个参数可以单独锁定,见下文 |
| 系统提示词 | 客户端请求没有系统提示词时由网关补上,见下文 |
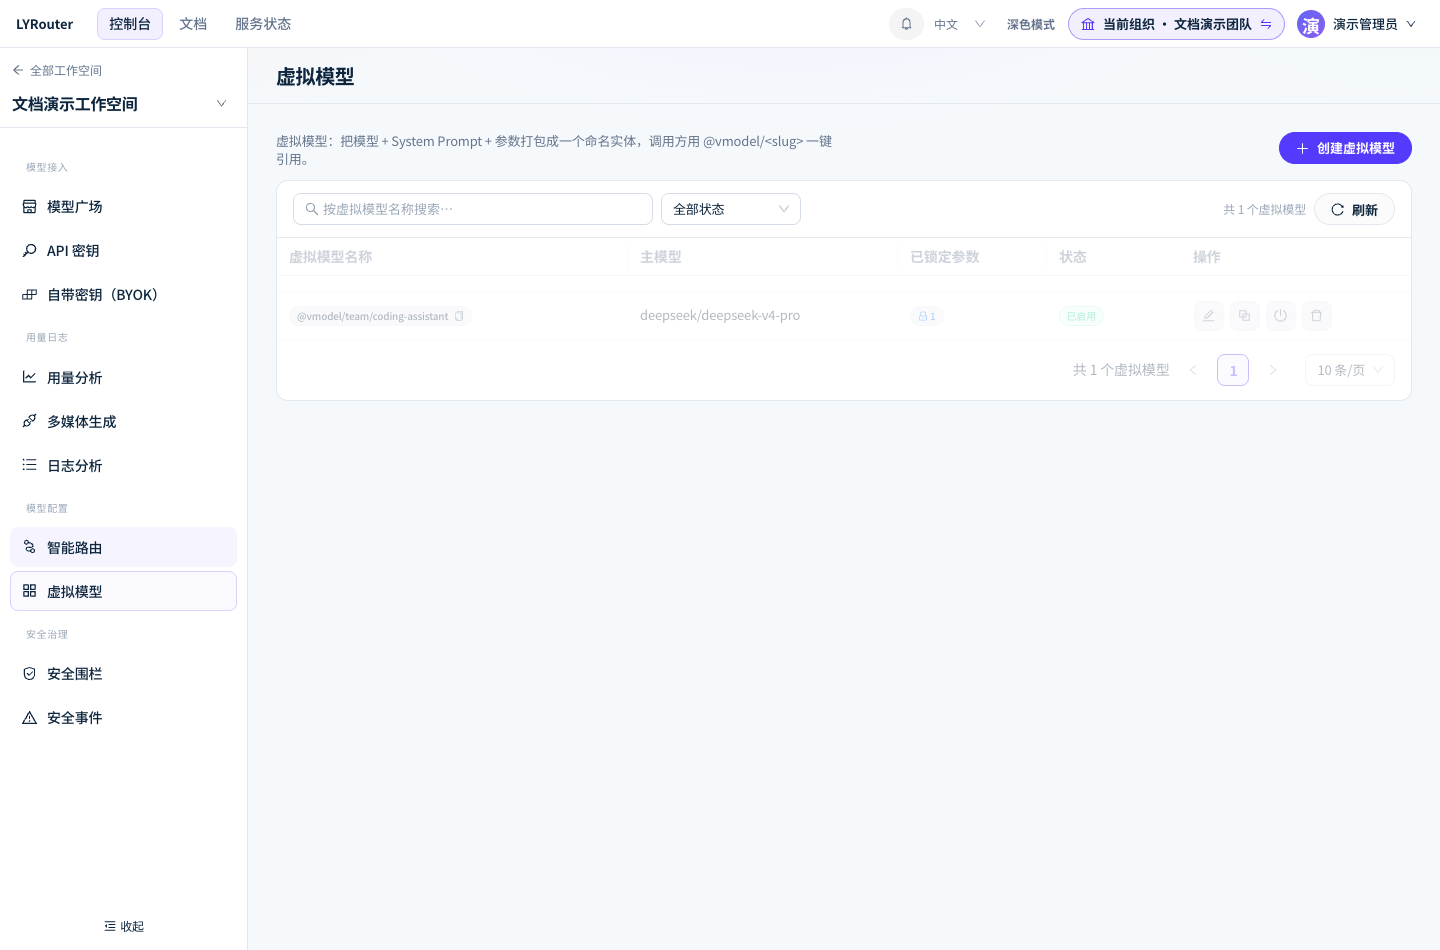
图 1:虚拟模型列表展示可复制的调用名称、主模型、锁定参数和启用状态。 截图为演示数据,点击图片可查看原图。
- 「默认模型」和「备用模型」可以从模型目录中选择,也可以直接输入模型 ID。保存时不检查这些模型在本工作空间是否可用,调用时会跳过不可用的模型。保存前请确认它们已在模型广场开通,或已配置可用的 BYOK。
- 保存后虚拟模型即为「已启用」,几秒内同步到网关,不需要更换 API Key。「保存并测试」按钮暂不可用,请直接发送一次调用验证。
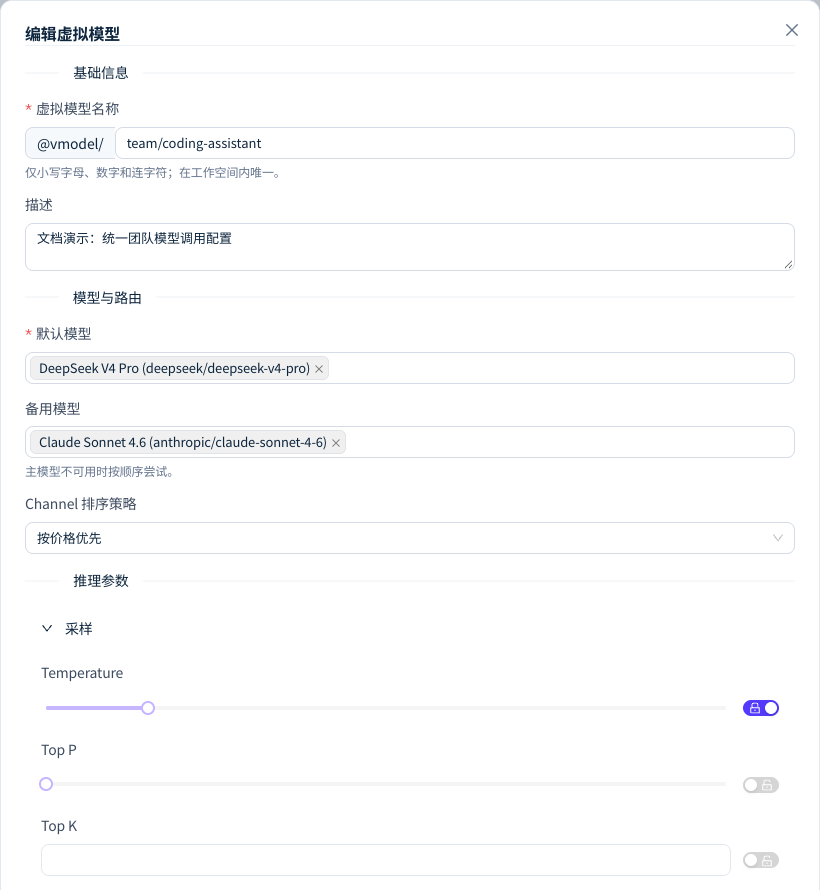
图 2:虚拟模型配置中设置主模型、备用模型和推理参数;按实际名称调用。 截图为演示数据,点击图片可查看原图。
保存失败的常见提示
| 提示 | 原因 |
|---|---|
| 虚拟模型名称需匹配 ^[a-z0-9][a-z0-9-]*$ | 名称含大写字母、空格或中文,或以连字符开头 |
| 请选择默认模型 | 没有填写「默认模型」 |
slug already in use in this workspace |
本工作空间已有同名虚拟模型 |
| JSON Schema 不是合法的 JSON,请检查语法。 | 「响应格式」的 JSON Schema 文本有语法错误 |
invalid preset params: response_format.json_schema.name is required ... |
JSON Schema 对象缺少非空的 name,见下文「推理参数」 |
| 请填写指定函数的名称 | 「工具选择」选了指定函数,但没有填写函数名 |
实际调用哪个模型
网关按以下顺序尝试,前一个模型的所有通道都失败后,才进入下一个模型:
- 虚拟模型的「默认模型」(主模型)。
- 「备用模型」,按填写顺序。网关不会因为某个备用模型更快或更便宜就把它提前。
- 工作空间的默认模型,前提是已在智能路由中设置。
同一个模型由多个通道提供时,按虚拟模型的「Channel 排序策略」排序;在 BYOK 中设置的「优先使用此 Channel」「仅用此 BYOK」仍然优先。完整的回退规则和不会回退的情况见失败重试与备用模型,其中两种最常见:
- 安全围栏的模型策略禁止了实际选中的模型时,请求立即返回 403
Request blocked by guardrail policy,不再尝试备用模型。围栏按实际模型 ID 检查,在模型策略里填写@vmodel/...不起作用。 - 当前模型不支持请求的输入或接口时(例如给只接受文本的模型发送图片),请求立即返回 400,不再尝试备用模型。因此备用模型应与主模型支持相同的输入类型和工具调用能力。
推理参数:默认值与锁定
每个参数在未锁定时是默认值,锁定后是强制值:
| 状态 | 客户端没传该参数 | 客户端传了该参数 |
|---|---|---|
| 未锁定 | 使用虚拟模型的值 | 使用客户端的值 |
| 已锁定 | 使用虚拟模型的值 | 使用虚拟模型的值,覆盖客户端的值 |
| 分组 | 参数 | 取值 |
|---|---|---|
| 采样 | temperature、top_p、top_k、seed |
0~2;0~1;≥0 的整数;整数 |
| 长度 | max_tokens、stop |
≥1 的整数;字符串或字符串数组 |
| 惩罚 | frequency_penalty、presence_penalty、repetition_penalty |
-2~2;-2~2;大于 0 |
| 输出格式 | response_format |
text、json_object、json_schema |
| 推理控制 | reasoning_effort、enable_thinking、thinking_budget |
minimal/low/medium/high;是或否;≥0 的整数 |
| 工具 | tool_choice、parallel_tool_calls |
auto、none、required 或指定函数;是或否 |
| 流式 | stream、stream_options.include_usage |
是或否;是或否 |
- 只有设置了值的参数才能锁定。
response_format、tool_choice这类对象参数整体替换,不逐字段合并。 - 未锁定的默认值不适用时会自动跳过:请求没有
tools时不补tool_choice;response_format为json_object而对话中没有出现 "json" 字样时不补。锁定的参数总是写入。 - 参数按 Chat Completions 的字段名原样合并,
/v1/responses请求也是如此,例如max_tokens不会换成max_output_tokens,上游可能因此返回 400。给 Responses 客户端使用的虚拟模型,建议只设置temperature、top_p这类两种协议通用的参数。 stream会改变响应形式:设为「是」并生效时,非流式请求也会收到 SSE 事件流。reasoning_effort、enable_thinking、thinking_budget分属不同厂商,网关不会相互换算,请按主模型所属厂商支持的那一个填写。- 「响应格式」选择 JSON Schema 时,要填 OpenAI
response_format.json_schema的完整对象,例如{"name": "answer", "schema": {"type": "object", "properties": {"text": {"type": "string"}}}}。只粘贴 Schema 本身会保存失败。 - 控件变灰并提示「当前主模型不支持该参数」只是控制台提示,网关不会按模型能力删减参数。
系统提示词何时注入
| 接口 | 注入规则 |
|---|---|
/v1/chat/completions |
messages 中没有 role 为 system 的消息时,插到最前面;已有则不注入 |
/v1/messages |
请求没有 system 时注入;已有则不注入 |
/v1/responses |
instructions 为空时直接填入;已有内容时空一行后追加 |
系统提示词不能锁定:Chat 和 Messages 请求自带系统提示词时,虚拟模型的提示词不生效。developer 角色的消息不算系统提示词。改用备用模型时会重新注入一次,不会重复叠加。
编辑、停用和删除
| 操作 | 对调用的影响 |
|---|---|
| 编辑 | 保存后新请求按新配置执行。修改名称等于修改调用名,旧名称立即失效 |
| 禁用 | 状态变为「已停用」,网关不再识别该名称,GET /v1/models 也不再列出 |
| 启用 | 原名称恢复可用 |
| 克隆 | 打开预填全部配置的创建表单,名称加 -copy 后缀,点击保存后才创建 |
| 删除 | 输入名称确认后永久删除,之后可以用同一名称重新创建 |
虚拟模型被禁用、删除或改名后,旧名称的请求不再匹配任何虚拟模型。工作空间设置了默认模型时,这类对话请求会改由默认模型回答;没有设置时返回 503 all routed candidates exhausted。
验证与常见问题
调用后在请求日志中打开这条记录,「路由追踪」的「虚拟模型」显示虚拟模型名称(不带 @vmodel/ 前缀),「模型(实际)」显示实际回答的模型,详见查看实际路由。
调用返回 503 all routed candidates exhausted,应该检查什么?
答: 先核对 @vmodel/<名称> 的拼写和大小写,再用 GET /v1/models 确认它在列表中,即处于已启用状态。名称无误时,请账号管理员确认「默认模型」和「备用模型」已在模型广场开通或配置了可用的 BYOK。
为什么回答来自虚拟模型之外的模型?
答: 主模型和备用模型都失败后,网关会使用工作空间的默认模型。名称写错或虚拟模型已停用时,对话请求也会直接由默认模型回答。在日志的「模型(实际)」中可以确认,不需要兜底时请账号管理员清空智能路由中的默认模型。
锁定参数后上游返回 400,怎么办?
答: 锁定的参数总是写入请求,上游不支持时会拒绝。打开日志的「原始报文」,对比「上游请求」与「上游响应」找到被拒绝的参数,再取消锁定或删除该参数。