多模态能力
除文本对话与向量外,网关还支持视觉理解(图片输入)、图像生成与编辑、视频生成。文本类接口(chat/completions、embeddings)见 调用网关。
本文覆盖网关上当前全部可调用的多模态模型,逐个列出接口、全部参数(含取值范围与默认值)、计费口径和可直接运行的示例。
模型的增减以控制台模型广场与
/v1/models为准。本文随模型上架定期更新,短期内可能有个别新模型尚未写入。
模型总览
图像生成 / 编辑(同步,直接在响应里拿图)
| 模型 | 接口 | 请求处理 | 计费 |
|---|---|---|---|
bytedance/doubao-seedream-5.0-pro |
/v1/images/generations |
透传 | 按张,分档 |
bytedance/doubao-seedream-5.0-lite |
/v1/images/generations |
透传 | 按张,不分档 |
openai/gpt-image-2 |
/v1/images/generations/v1/images/edits |
透传 | 按 token,四项 |
openai/gpt-image-2.5-flare |
同上 | 透传 | 按 token,三项 |
openai/gpt-image-2.5-sunburst |
同上 | 透传 | 同上 |
google/gemini-3-pro-image |
同上 | 契约转换 | 按 token,三项 |
google/gemini-3.1-flash-image |
同上 | 契约转换 | 按 token,两项 |
透传的在生成接口(/v1/images/generations)上也会丢掉几个参数:GPT-Image 系列固定丢 response_format,2.5 两个还丢 stream / stream_options。被丢的参数会在响应头 X-Gateway-Unsupported-Parameters 里列出。编辑接口(/v1/images/edits)不丢,这几个参数会转发给上游(只传 stream: true 时网关目前还会补上 stream_options,上游返回 400),不要传。
GPT-Image 的「四项」是输入文本 / 输入图片 / 输出 / 缓存命中,2.5 系列的 usage 不含缓存字段,只有前三项;Gemini 的「三项」是输入 / 输出 / 思考,只有 Pro 产生思考 token,Flash 只有前两项。Seedream pro 的参考图(输入图片)另计一项,每次请求第 1 张不收费。分档维度见各模型详情。
视频生成(异步任务)
| 模型 | 接口 | 请求处理 | 计费 |
|---|---|---|---|
bytedance/doubao-seedance-2.5 |
/v1/videos |
契约转换 | 按 token,分辨率 × 视频输入分档 |
bytedance/doubao-seedance-2.0-fast |
/v1/videos |
契约转换 | 按 token,按视频输入分档 |
bytedance/doubao-seedance-2.0-mini |
/v1/videos |
契约转换 | 同上 |
minimax/minimax-h3 |
/v1/videos/v1/videos/regenerations/v1/videos/context |
契约转换 | 按秒,按分辨率分档 |
minimax/minimax-h3-max⚠️ 已被服务商下线,目前不可用,请改用 minimax/minimax-h3 |
/v1/videos |
契约转换 | 按秒,按分辨率分档 |
MiniMax 的升清(/videos/regenerations)单独一档,参考图单独计一项;上下文增强(/videos/context)产出的是文本,按 token 计。
[!important] 本文不写具体单价。 价格随运营调整,不同环境(测试 / 生产)也不相同 —— 请以控制台模型广场上该模型的实时价格为准,逐次调用的实际扣费见查看日志。
这里只说明计费口径:按什么计量(张 / token / 秒 / 字符)、分成哪几项、按什么维度分档。口径是接口契约的一部分,不随调价变化。
视觉理解(图片输入、输出文本)
走标准 /v1/chat/completions,模型为带「视觉」能力标签的对话模型,见下文「视觉理解」一节。
鉴权与其它调用一致——始终用你的网关密钥作为 Bearer token,网关据此识别工作空间并注入上游凭据(你的密钥不会透传给上游):
Authorization: Bearer sk-你的密钥
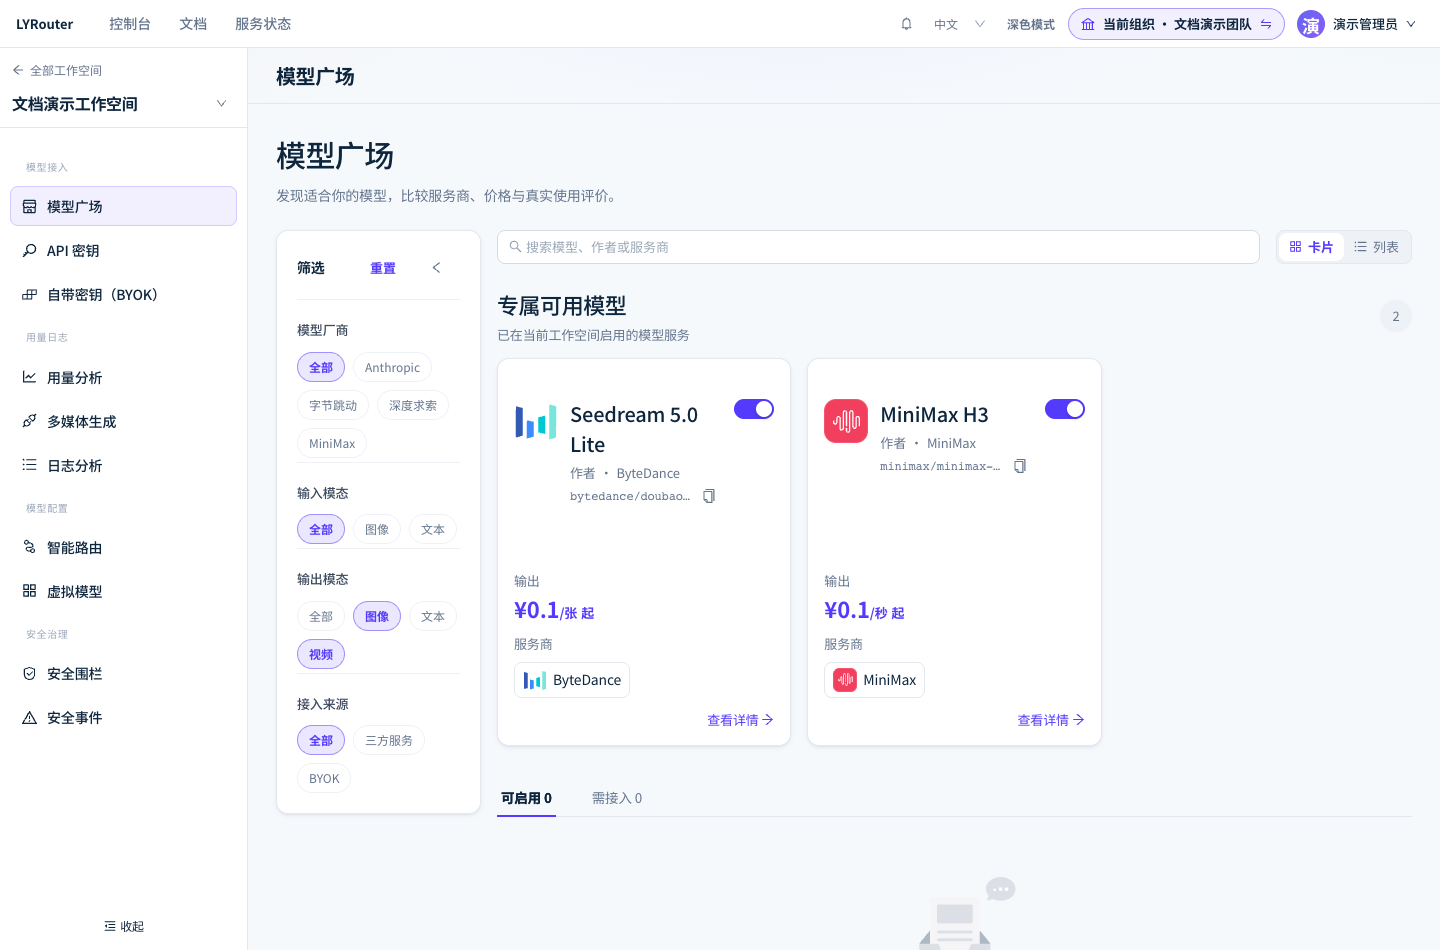
图 1:在输出模态中选择图像和视频,查看当前工作空间可用的多模态模型与计费单位。 截图为演示数据,点击图片可查看原图。
请求处理模式:透传与契约转换
读参数表之前先看这一节——同一个参数在不同模型上会不会生效,取决于这个模型走哪种模式。
| 模式 | 网关做什么 | 你该照谁的文档写参数 |
|---|---|---|
| 透传 | 请求体原样转发给上游,只改写模型名 | 厂商原生参数,厂商支持什么你就能用什么 |
| 契约转换 | 把网关的统一参数翻译成厂商的私有形状 | 网关契约(下文每个模型都列全了) |
两种模式都不会静默吞掉参数:
- 契约转换时,契约外的参数会被丢弃,并在响应头
X-Gateway-Unsupported-Parameters里逐个列出(Gemini 图像模型只转发prompt、model、image、size,其余都按此处理);视频模型对契约内但这个模型不支持的参数直接返回 400 并说明原因。例外见下文「视频通用参数(网关契约)」:Seedance 的reference_audio会被静默丢弃,用表单提交时也有几个字段不会按预期处理。 - 不想要这种"丢了也继续"的行为,请求时带上
X-Gateway-Strict-Parameters: true,被丢弃的参数会让请求直接返回 400,错误码unsupported_parameters。
有一类参数即使在透传模型上也会被有意丢弃:转发给上游只会让请求失败,而它又改变不了结果。目前只在 GPT-Image 系列的生成接口上:
response_format(该系列固定返回 base64,上游对这个参数时灵时不灵),以及 2.5 两个模型的stream/stream_options(上游会开启流式,导致请求失败)。丢弃同样会写进X-Gateway-Unsupported-Parameters,带X-Gateway-Strict-Parameters: true时同样返回 400。编辑接口不做这种丢弃。
视觉理解(图片输入对话)
图片输入走标准的 chat/completions,在 content 里以 image_url 携带图片(data: 内联 base64 或公网 URL),与 OpenAI 多模态格式一致:
curl https://api.lyrouter.com/v1/chat/completions \
  -H "Authorization: Bearer sk-你的密钥" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "支持视觉的模型名",
    "messages": [{
      "role": "user",
      "content": [
        { "type": "text", "text": "这张图里有什么?" },
        { "type": "image_url", "image_url": { "url": "https://example.com/cat.jpg" } }
      ]
    }]
  }'
需要选用支持视觉的模型(模型广场里带「视觉」能力标签)。给纯文本模型发图片会被上游拒绝。
图像生成与编辑(同步)
两个端点与 OpenAI 的图像 API 一致,请求发出后直接在响应里拿到图片,不需要轮询:
POST /v1/images/generations    文生图
POST /v1/images/edits          图生图 / 图像编辑
各模型耗时差别很大。 Seedream 约 20 秒;GPT-Image 系列一次生成实测约 20~60 秒(最长一次约 83 秒),生成接口上参数错误的 400 实测在 2 秒内返回;Gemini 3 Pro 实测 20~250 秒,偶有超过 300 秒仍未返回。客户端超时请按分钟级设置,不要沿用文本接口的 30 秒。
响应是 OpenAI 形状,产物固定在顶层 data[] 数组里:
{
  "created": 1760000000,
  "data": [ { "b64_json": "…" } ],
  "usage": { "input_tokens": 13, "output_tokens": 196, "total_tokens": 209 }
}
基本用法
文生图:
curl https://api.lyrouter.com/v1/images/generations \
  -H "Authorization: Bearer sk-你的密钥" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "bytedance/doubao-seedream-5.0-lite",
    "prompt": "一只戴墨镜的柴犬坐在冲浪板上,黄昏海面,电影感",
    "size": "2K"
  }'
图像编辑(multipart/form-data,把原图作为文件段上传):
curl https://api.lyrouter.com/v1/images/edits \
  -H "Authorization: Bearer sk-你的密钥" \
  -F model=openai/gpt-image-2 \
  -F quality=medium \
  -F image=@cat.png \
  -F prompt="把背景换成雪山"
图像编辑(JSON 形态)——把图片作为 base64 放在 JSON 体里:
curl https://api.lyrouter.com/v1/images/edits \
  -H "Authorization: Bearer sk-你的密钥" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "google/gemini-3-pro-image",
    "prompt": "把背景换成雪山",
    "image": "data:image/png;base64,iVBORw0KGgo…"
  }'
image 可以是单个字符串,也可以是字符串数组(多张参考图)。
Gemini 两个模型现在两种形态都收(2026-10-09 起)。它们的上游是 Google 原生
generateContent,只认 JSON(图片要落成inlineData)—— 收到 multipart 时网关会先把它 归一成字段表,再按契约翻译过去,所以官方 OpenAI SDK 的images.edit()也能直接驱动它们。在此之前这条路走不通。旧文档、旧版规格附件里「Gemini 只能用 JSON」的说法已经过期。
两种请求体的支持情况(2026-10-09 实测):
| 模型 | multipart(文件上传) | JSON(base64) |
|---|---|---|
openai/gpt-image-2 |
✅ | ✅ |
openai/gpt-image-2.5-flare |
✅ | ✅ |
openai/gpt-image-2.5-sunburst |
✅ | ✅ |
google/gemini-3-pro-image |
✅ | ✅ |
google/gemini-3.1-flash-image |
✅ | ✅ |
透传模型(GPT-Image 系列)的 multipart 路径上,网关只定位并改写
model字段, 文件段一个字节都不动。契约转换模型(Gemini 系)则相反:网关会解析 multipart、 把文件段转成 base64,再按该模型的契约重组请求体 —— 这也是它为什么有 30 MB 的内联上限。 JSON 路径同理:GPT-Image 系列的 JSON 请求体原样转发,图片由上游校验;Gemini 系的图片格式 优先取 data URI 里声明的 MIME,传裸 base64 时按 PNG / JPEG / WEBP / GIF 的字节特征识别, 都认不出时返回 400 并指明是第几张图 —— 网关不会替你挑一个默认格式。 另外请注意上游会校验图片本身:文件损坏或色彩模式不受支持的图片会被退回Invalid image file or mode,那是图片的问题,不是接口没接通。 Seedream 的图生图不走这个端点,走/v1/images/generations的image参数。
下面按模型列出全部参数。先看这个模型走哪种处理模式——透传的照厂商文档写,契约转换的照网关契约写。
Seedream 5.0 pro / lite(火山方舟)
两个模型都是透传——下表的参数原样送到上游,厂商支持什么就能用什么。
能力对比
| 能力 | doubao-seedream-5.0-pro |
doubao-seedream-5.0-lite |
|---|---|---|
| 文生图 | ✓ | ✓ |
| 文生组图(一次出多张) | 暂不支持 | ✓ |
| 单图 / 多图生图 | ✓ | ✓ |
| 单图 / 多图生组图 | 暂不支持 | ✓ |
| 交互编辑(坐标定位编辑) | ✓ | ✗ |
| 图层拆分(拆成底图 + 最多 16 图层) | ✓ | ✗ |
| 流式输出 | 暂不支持 | ✓ |
| 联网搜索 | 暂不支持 | ✓ |
| 可选分辨率档位 | 1K、1.5K、2K |
2K、3K、4K |
| 输出格式 | png、jpeg |
png、jpeg |
| 提示词优化模式 | 标准、极速 | 标准 |
| 生成数量限制 | 单图,或 1 底图 + 最多 16 图层 | 参考图数 + 生成图数 ≤ 15 |
| 限流 | 500 张/分钟 | 500 张/分钟 |
参数
| 参数 | 类型 | 默认 | 取值 | 说明 |
|---|---|---|---|---|
model |
string | — | 见上表 | 必填 |
prompt |
string | — | — | 提示词。图层拆分时可省略(不传则模型自动识别要拆的元素) |
image |
string / string[] | — | 图片 URL 或 data:image/<格式>;base64,<编码> |
参考图。生图场景建议不超过 10 张(超过时服务商目前不拒绝,但输出可能异常);图层拆分仅支持 1 张 |
size |
string | 2K(生图)/ auto(图层拆分) |
见下 | 两种写法不可混用 |
response_format |
string | url |
url、b64_json |
|
output_format |
string | — | png、jpeg |
图层拆分时只控制底图格式,图层恒为 png |
background |
string | opaque |
transparent、opaque |
透明通道。仅图生图、且只支持输入 1 张带透明通道的图 |
watermark |
boolean | true |
true、false |
true 在右下角加「AI生成」水印;不传时默认加,不需要时传 false |
layer_decomposition |
boolean | false |
true、false |
仅 pro。开启后 image 变为必填且只能 1 张 |
optimize_prompt_options.mode |
string | standard |
standard、fast |
仅 pro。fast 更快、质量略低 |
size 的两种写法
方式 1,指定档位(推荐):传 1K / 1.5K / 2K(pro)或 2K / 3K / 4K(lite),宽高比在 prompt 里用自然语言描述,由模型决定具体像素。pro 的档位映射(常见值,不限于此):
| 档位 | 1:1 | 4:3 | 16:9 | 9:16 | 3:2 | 21:9 |
|---|---|---|---|---|---|---|
| 1K | 1024×1024 | 1152×864 | 1424×800 | 800×1424 | 1248×832 | 1568×672 |
| 1.5K | 1536×1536 | 1792×1344 | 2048×1152 | 1152×2048 | 1872×1248 | 2352×1008 |
| 2K | 2048×2048 | 2368×1776 | 2816×1584 | 1584×2816 | 2496×1664 | 3136×1344 |
1.5K与1K价格相同,但出图效果更好。
方式 2,指定宽高像素(宽x高,如 2048x1024):
- 总像素(宽 × 高):pro 范围 [921600, 4624220];lite 不少于 3686400(最小正方形是
1920x1920,常见的1024x1024会被拒绝) - 宽高比(宽/高)范围 [1/16, 16]
- 两条必须同时满足。
512x512总像素 262144,低于两款的下限,无效
图层拆分场景只支持档位写法,默认 auto:输入图在 [921600, 4624220] 之间按原尺寸输出;小于 1K 按 1K;大于 2K 按 2K。
交互编辑(仅 pro)
在 prompt 里用坐标标签指定编辑位置,坐标归一化到 0~999(左上角 0,0,右下角 999,999):
- 点选:
<point>x y</point>,由模型判断影响范围 - 框选:
<bbox>x1 y1 x2 y2</bbox>,精确控制区域
换算:x = round(x_px / 展示宽 * 1000),y 同理。
| 场景 | 提示词写法 |
|---|---|
| 编辑指定点附近的对象 | 把图1<point>520 460</point>位置换成皇冠 |
| 编辑指定区域的对象 | 把图1<bbox>120 180 640 760</bbox>区域替换成花园 |
| 跨图片编辑 | 将图1<bbox>179 283 796 986</bbox>的主体放到图2<bbox>118 331 933 871</bbox>位置 |
框选区域内有多个主体时,在提示词里补一句说明要编辑哪个(「左侧的人」「戴帽子的猫」)。需要保持不变的物体也可以一并框出来并写明「保持不变」。
也可以不用坐标,直接在参考图上手绘草图 / 涂鸦 / 圈选,再用自然语言描述标记位置。
图层拆分(仅 pro)
layer_decomposition: true 把单张图拆成 1 张底图和最多 16 个带透明通道的 PNG 图层。
curl https://api.lyrouter.com/v1/images/generations \
  -H "Authorization: Bearer sk-你的密钥" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "bytedance/doubao-seedream-5.0-pro",
    "image": "https://example.com/poster.png",
    "size": "2K",
    "layer_decomposition": true,
    "watermark": false
  }'
响应的 data[] 同时包含底图与图层:
| 字段 | 出现在 | 含义 |
|---|---|---|
url |
底图、图层 | 下载链接,仅保留 24 小时 |
z_index |
底图、图层 | 叠放顺序。底图固定 0,图层递增 |
bounding_box.absolute |
图层 | [left, top, right, bottom],输出底图坐标系中的绝对像素位置 |
bounding_box.normalized |
图层 | 同上但归一化(0~1000),用于还原到任意尺寸画布 |
name、description |
图层 | 图层名称与内容描述 |
还原到底图:x = left,y = top,w = right - left,h = bottom - top,按 z_index 从小到大叠放。
还原到 W × H 的画布:x = left / 1000 × W,其余同理(归一化坐标是整数,换算有取整误差)。
拆出的图层可以作为输入图再次送进模型单独编辑;想保留透明背景就同时传 background: transparent 和 output_format: png。
图层拆分每次请求预扣 17 张的限流额度(按最大输出张数预留),生成完成后按实际张数返还。
输入图限制
| 约束 | 生图场景 | 图层拆分场景 |
|---|---|---|
| 格式 | jpeg、png、webp、bmp、tiff、gif、heic、heif | png、jpeg |
| 总像素(宽×高) | [196, 36,000,000] | [262144, 36,000,000] |
| 宽高长度 | ≥ 14 px | — |
| 宽高比(宽/高) | [1/16, 16] | [1/16, 16] |
| 单张大小 | ≤ 30 MB | ≤ 30 MB |
| 张数 | 建议不超过 10 张(超过时服务商目前不拒绝,但输出可能异常) | 仅 1 张 |
base64 需遵循 data:image/<格式>;base64,<编码>,<格式> 必须小写。
计费
按张计,分档维度是分辨率档位与是否图层拆分:
| 模型 | 分档 |
|---|---|
doubao-seedream-5.0-pro |
1K / 1.5K(≤ 261 万像素)一档,2K 一档 |
doubao-seedream-5.0-pro |
图层拆分时另有两档(同样按 1K/1.5K 与 2K 分) |
doubao-seedream-5.0-lite |
不分档 |
seedream-5.0-pro 的参考图单独计一项:每次请求的第 1 张参考图不收费,超出部分按张计费。这里数的是输入的参考图,不是出图张数。图层拆分按实际产出的图片张数(底图 + 各图层)计费。
1.5K与1K同档同价,出图更好——没有特殊理由时优先用1.5K。
GPT-Image-2 / 2.5-flare / 2.5-sunburst
透传,参数与 OpenAI 图像 API 一致。
| 参数 | 类型 | 必填 | 取值 | 说明 |
|---|---|---|---|---|
model |
string | 是 | openai/gpt-image-2、openai/gpt-image-2.5-flare、openai/gpt-image-2.5-sunburst |
|
prompt |
string | 是 | — | |
quality |
string | 见说明 | 逐模型不同,见下表 | gpt-image-2 必填;建议所有 GPT-Image 模型都显式传入 |
size |
string | 否 | 宽x高 |
只接受 宽x高,不接受档位名;须满足下文四条硬约束,否则 400 |
n |
integer | 否 | 最大 10 | 出图张数 |
user |
string | 否 | — | 终端用户标识 |
quality 逐模型取值:
| 模型 | 取值 | 默认 |
|---|---|---|
gpt-image-2 |
low、medium、high、auto |
无,必填:不传会间歇性返回 400(INVALID_REQUEST_BODY);auto 实测等同 low |
gpt-image-2.5-flare、gpt-image-2.5-sunburst |
low、medium、high、xhigh、max、auto |
low(auto 实测等同 low) |
xhigh、max 两档是否可用由上游账号能力决定,可能被拒;收到 Invalid value: 'xhigh' 时改用 high。
size 的四条硬约束(由服务商校验,任一不满足返回 400):
| 约束 | 服务商报错原文 | 示例 |
|---|---|---|
| 宽和高都能被 16 整除 | Invalid size '<宽>x<高>'. Width and height must both be divisible by 16. |
1008x1008 ✓;1254x1254、1312x1199 ✗ |
| 最长边 ≤ 3840 | Invalid size '<宽>x<高>'. The longest edge must be less than or equal to 3840. |
3840x2160 ✓;4096x4096、1024x4096 ✗ |
| 总像素不少于约 100 万 | Invalid size '<宽>x<高>'. Requested resolution is below the current minimum pixel budget. |
1008x1008(约 102 万)✓;512x1024(约 52 万)✗ |
| 总像素不超过约 830 万 | Invalid size '<宽>x<高>'. Requested resolution exceeds the current pixel budget. |
3840x2160(约 829 万)✓;3840x2176(约 836 万)✗ |
GPT-Image 不接受档位名:传 4K 返回 Invalid size '4K'. Expected WIDTHxHEIGHT, for example '1824x1024'.
生成接口上
response_format会被丢弃。 这个系列固定返回 base64,而上游对该参数的处理不稳定(实测同一模型、同一套参数,21 分钟内在 400 与 200 之间来回翻)。网关统一丢弃它并在X-Gateway-Unsupported-Parameters里说明,把「随机失败」换成「确定行为」。2.5 系列同时丢弃stream/stream_options——传了上游会开启流式,导致请求失败(500)。编辑接口(
/v1/images/edits)上网关不丢弃这几个参数,会转发给上游,请不要传:只传stream: true时网关目前还会自行补上stream_options,上游返回 400Unknown parameter: 'stream_options'.
一次生成要几十秒。 实测约 20~60 秒(最长一次约 83 秒,
gpt-image-2.5-flare);参数错误导致的 400 实测在 2 秒内返回。客户端超时仍请按分钟设置。
计费
按 token 计:输入文本、输入图片、输出各有独立单价。缓存命中另有一项单价,但 2.5 系列的 usage 不含缓存字段,不产生这一项。
上游在 usage.input_tokens_details 里分开报文字与图片 token,网关按两个单价分别计费 —— 所以同样长度的提示词,带图片和不带图片的费用不同。
输出 token 主要由 quality 决定:1024x1024 时 2.5 系列 low 输出 196 token、max 输出 7024 token,最高档约为最低档的 36 倍。同名档位在两代模型上不是同一个量 —— 2.5 系列的 high 与 gpt-image-2 的 medium 输出 token 相同,跨模型比较请比 token,不要比档位名。
GPT-Image 不是像素越多越贵(只适用于 GPT-Image):输出 token 不随像素增加,例如
1024x1536(约 157 万像素)的输出 token 比1024x1024(约 105 万像素)还少。
Gemini 3 Pro Image / 3.1 Flash Image
这两个走契约转换——网关把统一参数翻译成 Gemini 原生的 generateContent 形状。因此只有下表这些参数会被送出去:
| 参数 | 是否生效 | 说明 |
|---|---|---|
model |
✓ | google/gemini-3-pro-image、google/gemini-3.1-flash-image |
prompt |
✓ | 翻译成 contents[].parts[].text。必填,不写或为空返回 400 |
size |
✓ | 见下,两种写法行为不同 |
image |
✓ | 参考图 / 待编辑图,一张或多张,翻译成 inlineData。data URI 取其中声明的格式;裸 base64 按 PNG / JPEG / WEBP / GIF 的字节特征识别,认不出时返回 400 并指明第几张图。不接受图片 URL |
n |
丢弃 | Gemini 的候选数参数属于文本生成,图像端点上是否生效没有证据。宁可明示丢弃,也不编一个「请求 200、设置静默不生效、账单照出」的映射 |
quality |
丢弃 | Gemini 契约里没有这个概念 |
response_format |
丢弃 | 只能返回 base64(b64_json) |
user 及其他参数 |
丢弃 | — |
被丢弃的参数会出现在响应头 X-Gateway-Unsupported-Parameters 里;带 X-Gateway-Strict-Parameters: true 则直接 400。
size:档位名或宽高
| 写法 | 映射到 | 实际效果 |
|---|---|---|
档位名(1K、2K、4K) |
imageConfig.imageSize |
只控制分辨率,宽高比由上游默认。各档输出 token 见下表 |
宽高(1376x768) |
imageConfig.aspectRatio + imageConfig.imageSize |
先匹配最接近的支持比例(误差 2% 以内),再按长边向上取分辨率档位,比例与分辨率都生效 |
宽高比超出 2% 误差(如 1000x700) |
整个 size 不下发 |
比例和分辨率档都被丢弃,按上游默认的比例和分辨率出图。请求仍返回 200、仍出图、仍计费,唯一的信号是响应头 X-Gateway-Unsupported-Parameters: size;严格模式下返回 400 |
不要使用
512档。512档在生产环境被服务商拒绝(两个模型都是)。写宽高时长边不超过 704 会被网关映射到512档,同样可能被拒绝,请让长边大于 704。
写宽高时按长边向上取档,超过 4K 的按 4K。同一档位在两个模型上的输出 token 不同:
| 长边 | 档位 | gemini-3-pro-image 输出 token |
gemini-3.1-flash-image 输出 token |
|---|---|---|---|
| ≤ 1376 | 1K |
1120 | 1120 |
| ≤ 2816 | 2K |
1120(2K 档不生效,与 1K 相同) | 1680 |
| 更大(封顶) | 4K |
2000 | 2520 |
出图尺寸由服务商按比例档和分辨率档决定,不等于请求的宽高,例如 gemini-3-pro-image 请求 4096x2304 实际出图 5504x3072;请以返回图片的实际宽高为准。
例如 1024x1024 映射为 1:1 + 1K,2048x2048 映射为 1:1 + 2K。
向上取档意味着长边略超过某一档时会落到下一档:
1500x1500取的是2K档,账单按实际输出的 token 收。想精确控制分辨率就直接传档位名。比例偏差超过 2% 时整个
size被丢弃、请求照常成功,生产环境建议带X-Gateway-Strict-Parameters: true,让这种请求改为返回 400。要 16:9 + 4K 请写4096x2304,不要照抄5632x3072(比例 1.833,偏离 16:9 超过 2%,会被丢弃)。
size不接受比例字符串:16:9会被当作档位名原样传给上游,上游不认识,返回 400(upstream_rejected)。要 16:9 请写该比例的宽高,如1376x768。
支持的宽高比:1:1、2:3、3:2、3:4、4:3、4:5、5:4、9:16、16:9、21:9、1:4、4:1、1:8、8:1。传宽高时匹配误差 2% 以内的最接近比例,超出误差则比例和分辨率档都不下发,size 计入丢弃参数。
计费
按 token 计:输入、输出各有独立单价;gemini-3-pro-image 另有思考一项(usage.output_tokens_details.reasoning_tokens,usage.total_tokens 包含它),gemini-3.1-flash-image 不产生思考 token。带参考图时,输入图片并入「输入」。
思考 token(Pro)单独计费且不可预测。 只有
gemini-3-pro-image产生思考 token。生产实测每次 115~316 个、中位约 220,由模型自行决定,不随输出分辨率档位或提示词长度变化;它约占单次费用的 1.5%,预算时可按每次约 220 个估算。
视频生成(异步任务)
视频生成耗时以分钟计,走异步任务:提交拿任务 ID,轮询到终态,再取产物。
POST /v1/videos                 提交任务
GET  /v1/videos/{id}            查询任务
GET  /v1/videos/{id}/content    取产物
POST /v1/videos/regenerations   视频升清(仅 MiniMax H3)
POST /v1/videos/context         上下文增强(仅 MiniMax H3)
三步流程
第一步,提交:
curl https://api.lyrouter.com/v1/videos \
  -H "Authorization: Bearer sk-你的密钥" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "bytedance/doubao-seedance-2.0-mini",
    "prompt": "一只柯基在草地上奔跑,阳光穿过树叶",
    "size": "1280x720",
    "seconds": 5
  }'
返回任务对象,status 为 queued:
{ "id": "aigwt_…", "object": "video", "model": "…", "status": "queued", "created_at": 1760000000 }
第二步,轮询:GET /v1/videos/{id},直到 status 变成 completed 或 failed。建议 10~30 秒一次。
第三步,取产物:GET /v1/videos/{id}/content 返回 302,跳转到产物地址下载。任务还没完成时返回 409,error.code 为 not_ready,继续轮询到 completed 再取。
产物地址有效期很短(厂商侧通常 24 小时),请及时下载或转存。
视频通用参数(网关契约)
下面这些参数对所有视频模型通用,网关会翻译成各厂商的私有形状:
| 参数 | 类型 | 说明 |
|---|---|---|
model |
string | 模型名 |
prompt |
string | 提示词 |
seconds |
integer | 时长(秒),正整数 |
size |
string | 宽x高(如 1280x720)或档位名(如 720p、2K) |
first_frame |
string | 首帧图片 |
last_frame |
string | 尾帧图片 |
reference_image |
string / string[] | 参考图 |
input_reference |
string / string[] | 参考视频 |
reference_audio |
string / string[] | 参考音频(目前仅 MiniMax H3 支持,不会转发给 Seedance) |
generate_audio |
boolean | 生成有声视频。Seedance 不传时默认生成有声视频 |
watermark |
boolean | 加水印 |
output_format |
string | 输出容器格式 |
omni_reference_task_type |
string | 全模态任务类型(Seedance 使用;2.5 和 2.0 系列传入都会被受理) |
source_video |
string | 升清源视频(仅 /v1/videos/regenerations) |
不在这张表里的字段会被丢弃并写进 X-Gateway-Unsupported-Parameters;表里的字段若该模型不支持,会被显式拒绝并说明原因,不会悄悄忽略。JSON 请求体里目前已知的例外只有 reference_audio:传给 Seedance 时被静默丢弃,既不报错,也不会写进 X-Gateway-Unsupported-Parameters。用表单提交时的例外见下一段。
用 multipart/form-data 提交 /v1/videos 时(OpenAI 官方 SDK 的 videos.create() 就用这种格式),表单里能正常使用的只有 model、prompt、seconds、size、input_reference、watermark、generate_audio、output_format、omni_reference_task_type,其中 input_reference 只能填可公开访问的 https:// 地址。目前表单里的 input_reference 如果是上传的文件,网关会忽略这个文件、按没有参考视频处理并照常计费,不会报错;只有写成非 URL 的文本值时才返回 400 input_reference must be a URL; …。first_frame、last_frame、reference_image、reference_audio 请用 JSON 请求体提交:目前写在表单里时,网关会把它们换成占位值转给服务商,例如 Seedance 带 first_frame 时返回 400 The parameter `content[1].image_url` specified in the request is not valid.,MiniMax 带 reference_audio 时任务提交成功、随后异步失败(content[1].audio_url: invalid param: audio url must be http(s):// or data:...;base64)。
厂商文档里的
duration/resolution/ratio/content对应网关的seconds/size/ 由size推导 / 由上面的参考字段组装。请用网关的名字,厂商原名不在契约里,会被丢弃。
Seedance 2.5 / 2.0-fast / 2.0-mini(火山方舟)
能力对比
| 能力 | doubao-seedance-2.5 |
doubao-seedance-2.0-fast |
doubao-seedance-2.0-mini |
|---|---|---|---|
| 文生视频 | ✓ | ✓ | ✓ |
| 首帧 / 首尾帧生视频 | ✓ | ✓ | ✓ |
| 图片参考 / 视频参考 | ✓ | ✓ | ✓ |
| 音频参考 | ✗ 网关目前不转发 | ✗ 同左 | ✗ 同左 |
| 编辑视频 / 延长视频 | ✓ | ✓ | ✓ |
| 生成有声视频 | ✓ | ✓ | ✓ |
| 参考素材上限 | 30 图 + 1 视频 | 9 图 + 1 视频 | 9 图 + 1 视频 |
| 输出分辨率 | 480p、720p、1080p(10bit) | 480p、720p | 480p、720p |
| 输出宽高比 | 21:9、16:9、4:3、1:1、3:4、9:16、自适应 | 同左 | 同左 |
| 输出时长 | 4~30 秒 | 4~15 秒 | 4~15 秒 |
| 输出格式 | mp4、mov | mp4 | mp4 |
reference_audio(参考音频)目前不会转发给 Seedance:传了不报错,也不会出现在X-Gateway-Unsupported-Parameters中。需要参考音频时请改用 MiniMax H3。- 参考视频
input_reference每次只能传一个地址,写成数组返回 400。 - 服务商的联网搜索、返回尾帧等能力没有对应的网关参数,目前无法通过 LYRouter 使用。
Seedance 2.5 的 1080p 采用 10bit 位深 + H.265/HEVC 编码,少数播放器不兼容;
mov采用 H.264 + yuv444p + PCM,建议用 VLC / mpv / ffplay / IINA 播放。
size 的两种写法
| 写法 | 网关怎么处理 |
|---|---|
宽x高(如 1280x720) |
取短边作为分辨率档(→ 720p),并按宽高比就近匹配到厂商支持的比例 |
档位名(如 720p、1080p) |
原样送出,宽高比由厂商按提示词自适应 |
任务类型与特殊限制
Seedance 会根据输入素材和提示词自动判断任务类型,不同类型有不同的硬限制:
| 任务类型 | 怎么触发 | 限制 |
|---|---|---|
| 文生视频 | 只传 prompt |
无特殊限制 |
| 首帧 / 首尾帧 | 传 first_frame(+ last_frame) |
输出宽高比自动跟随首帧图片 |
| 参考生视频 | 传 reference_image / input_reference |
无特殊限制 |
| 视频编辑 | 传 input_reference + 提示词表达编辑意图 |
不要传 seconds;输出宽高比与时长自动跟随源视频;源视频时长须 4~30 秒 |
| 视频延长 | 传 input_reference + 提示词表达延长意图 |
输出宽高比自动跟随源视频 |
视频编辑任务不能指定时长。 厂商要求该场景时长固定跟随源视频,网关的
seconds只接受正整数,所以编辑任务请直接不传seconds,让厂商用默认值。传了会被厂商拒绝(InvalidParameter.TaskTypeConstraint)。
用 omni_reference_task_type 显式声明任务类型,可以把厂商的异步报错提前成同步报错(提交时就失败,而不是任务跑到一半失败):
| 值 | 含义 | 提示词需包含的关键词 |
|---|---|---|
auto(默认) |
由模型判断 | — |
reference |
参考生视频 | — |
edit |
视频编辑 | 编辑视频 / 增加 / 加上 / 删除 / 去掉 / 修改 / 替换 / 改成 |
extend |
视频延长 | 向前延长 / 向后延长 / 延续 / 续写 |
服务商只在多模态参考场景接受 edit、extend:用在文生视频(只传 prompt)上会在提交时返回 400 InvalidParameter.TaskTypeConstraint。
声明的类型与模型实际判定的不一致时,可能异步失败(InvalidParameter.TaskTypeMismatch),也可能按声明的类型执行并计费:实测声明 edit、提示词不含编辑关键词时,任务按编辑完成。提示词里用 @视频1、@图像1 指代参考素材。
输入素材限制(Seedance 2.5)
| 限制 | |
|---|---|
| 图片 | jpeg、png、webp、bmp、tiff、gif、heic、heif;宽高 [300, 6000] px;宽高比 [0.4, 2.5];单张 ≤ 30 MB;首帧 1 张 / 首尾帧 2 张 / 参考图 1~30 张 |
| 视频 | mp4、mov(H.264 或 H.265,音频 AAC/MP3/PCM);分辨率 480p 或 720p;时长 [2,30] 秒(编辑任务 [4,30]);宽高 [300,6000] px;宽高比 [0.4,2.5];单个 ≤ 200 MB;帧率 [24,60] |
| 请求体 | 总大小 ≤ 64 MB,大文件请用公网 URL,不要用 base64 |
Seedance 不接受含真人人脸的参考图 / 参考视频,会被输入审核拦截。
计费
按输出 token 计(任务对象中的 usage.completion_tokens),分档维度是分辨率与有无视频输入:
| 模型 | 分档 |
|---|---|
doubao-seedance-2.5 |
480p/720p 与 1080p 两档,每档再按有无视频输入分 |
doubao-seedance-2.0-fast |
只按有无视频输入分两档 |
doubao-seedance-2.0-mini |
同上 |
「有视频输入」指请求带了参考视频 input_reference(参考视频、视频编辑、视频延长);只传首帧 / 首尾帧的图生视频不算。有视频输入时按另一档单价计费,单价更低,但总价更高:带参考视频时计量的 token 大约翻倍(见下文「等效秒」)。
token 数 = 固定开销 + 每秒 token × 等效秒,已经完整体现了分辨率与时长的差异(实测 480p 4 秒 ≈ 40,594 token,8 秒 ≈ 80,770,720p 4 秒 ≈ 87,300),所以不需要再按时长分档。不带参考视频时,等效秒就是输出秒数。
带参考视频时,计量的是「等效秒」,不是输出时长:
| 输出时长 | 等效秒 |
|---|---|
| ≤ 6 秒 | 输出秒数 + 参考视频秒数 |
| > 6 秒 | 1.5 × 输出秒数 + 2,与参考视频时长无关 |
6 秒是拐点。例如参考视频 5 秒时,输出 5 秒按 10 秒计量,输出 10 秒按 17 秒计量。
MiniMax H3 / H3-Max
minimax/minimax-h3-max已被服务商下线,目前不可用,请改用minimax/minimax-h3。现在提交 H3-Max 任务会返回 HTTP 200,但任务对象是空的、没有任务 ID,无法轮询,也不扣费。本节保留 H3-Max 的差异说明,仅供对照。
能力对比
minimax/minimax-h3 |
minimax/minimax-h3-max(已下线) |
|
|---|---|---|
| 定位 | 标准版 | 极速版 |
| 分辨率 | 480P、768P、2K |
480P、768P(不支持 2K) |
| 时长 | 4~15 秒 | 5~15 秒(不支持 4 秒) |
| 文生视频 / 图生视频(首尾帧) | ✓ | ✓ |
| 多模态参考(图 / 视频 / 音频) | ✓ | ✓,但不支持多张参考图(服务商会拒绝并建议改用 H3) |
视频升清 /v1/videos/regenerations |
✓ | ✗ |
上下文增强 /v1/videos/context |
✓ | ✗ |
size:短边必须正好落在档位上
| 写法 | 网关怎么处理 |
|---|---|
档位名(480P、768P、2K) |
原样送出 |
宽x高 |
取短边查档位表:短边必须精确是 480 或 768,否则网关直接拒绝并告诉你合法值;宽高比按就近匹配 |
网关在这里替你拒,而不是把一个拼出来的档位发给厂商——厂商只会回一句「ratio 非法」,看不出是尺寸引起的。
size 和 seconds 在 MiniMax 上都要显式传:服务商要求提供分辨率和时长,网关不补默认值。
480P 档实际产物的短边是 576:实测文生视频用 480P、多模态参考生视频用 854x480,产物都是 1038×576。
三种输入场景与 ratio 规则
| 场景 | 怎么传 | 宽高比 |
|---|---|---|
| 文生视频 | 只传 prompt |
必须显式指定,不能自适应。size 写 宽x高 时网关按就近比例推导;写档位名或不写时按 16:9 |
| 图生视频 | first_frame(+ last_frame) |
由输入图决定,传了也会被忽略。实测 1:1 的首尾帧加 854x480 产出 768×768 |
| 多模态参考生视频 | reference_image / input_reference / reference_audio |
可选,默认自适应 |
图生视频与多模态参考互斥:传了
reference_*就不能再传first_frame/last_frame,反之亦然。
这个模型明确不支持的参数
以下参数在网关契约里存在(别的模型用得上),但 MiniMax 没有对应概念,传了会被显式拒绝并说明原因,不会悄悄忽略:
generate_audio(有声由参考音频承载)、output_format(没有容器格式选项)、omni_reference_task_type(没有全模态任务类型)、source_video(只属于升清接口)。
输入素材限制
| 限制 | |
|---|---|
| 图片 | JPG、JPEG、PNG、WEBP、HEIC、HEIF;宽高 [256, 5760] px;宽高比 [0.4, 2.5];≤ 30 MB;首帧 ≤ 1、尾帧 ≤ 1、参考图 ≤ 9 |
| 视频 | MP4、MOV(视频 H.264/H.265,音频 AAC/MP3);≤ 50 MB;≤ 3 个;单段 [2,15] 秒且总时长 ≤ 15 秒;宽高 [256,5760] px;宽高比 [0.4,2.5];帧率 [23.976, 60] |
| 音频 | WAV、MP3;≤ 15 MB;≤ 3 个;单段 [2,15] 秒且总时长 ≤ 15 秒 |
| 请求体 | 总大小 ≤ 64 MB,大文件请用公网 URL |
视频升清(/v1/videos/regenerations)
把一条 H3 768P 产物重新生成为 2K。只支持 H3 自己产出的、符合 768P 规格的视频,不是通用的视频放大。
curl https://api.lyrouter.com/v1/videos/regenerations \
  -H "Authorization: Bearer sk-你的密钥" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "minimax/minimax-h3",
    "prompt": "生成那条 768P 时实际送入模型的最终提示词",
    "source_video": "https://example.com/h3-768p.mp4",
    "size": "2K"
  }'
源视频必须满足:含音轨、24 fps、宽和高都能被 32 整除、面积在 589,824 ~ 1,032,192 像素之间、总帧数 107~362(每档递增 17 帧,约 4~15 秒)。
prompt必须是生成 768P 时实际送入模型的最终提示词,参考素材也要与当时一致。任何输入不一致都可能拿不到预期效果。如果当时用过上下文增强,要用增强之后的提示词。
上下文增强(/v1/videos/context)
把多模态上下文理解成一段结构化的、语义更丰富的提示词。这个接口只返回文本,不生成视频。
curl https://api.lyrouter.com/v1/videos/context \
  -H "Authorization: Bearer sk-你的密钥" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "minimax/minimax-h3",
    "prompt": "史诗级太空歌剧预告:女舰长独自站在观景窗前",
    "seconds": 5
  }'
同样是异步任务,轮询到终态后产物是文本(增强后的提示词),拿去喂给 /v1/videos 即可。这个接口的 seconds 是必填的(4~15)。
目前网关不会拒绝用其他模型调用这个接口:用 Seedance 模型调用会生成一条普通视频并按视频计费,拿不到增强后的提示词。上下文增强请只用
minimax/minimax-h3。
计费
视频按秒计,按分辨率分档:
| 模型 | 分档 |
|---|---|
minimax-h3 |
480P / 768P / 2K 三档;升清(/videos/regenerations)单独一档 |
minimax-h3-max(已被服务商下线,目前不可用,请改用 minimax-h3) |
480P / 768P 两档 |
参考图单独计一项(两个模型的参考图单价不同):minimax-h3 的参考图前 5 张免费,超出部分按张计费。
上下文增强(/videos/context)按 token 计,输入与输出两项分开 —— 它产出的是文本,不是视频。
计费秒数是输入 + 输出的总和(任务对象中的
usage.duration_seconds)。传了参考视频时,参考视频的秒数同样计入。升清(/videos/regenerations)例外:duration_seconds只计源视频的秒数(源视频 4 秒计 4 秒)。
在代码里调用
前面每一节给的都是 curl,便于逐个参数对照。下面按任务分组,点开即可取用 —— 每组内切换语言。
所有接口共用同一个 base 与同一把密钥:
base_url = https://api.lyrouter.com/v1
header   = Authorization: Bearer sk-你的密钥
超时按分钟设。 图像同步接口实测最长约 250 秒(Gemini 3 Pro),偶有超过 300 秒仍未返回;沿用文本接口的 30 秒会在成功返回之前就被客户端切断。视频一律走异步轮询。
import httpx

BASE = "https://api.lyrouter.com/v1"
H = {"Authorization": f"Bearer {KEY}"}

r = httpx.post(f"{BASE}/images/generations", headers=H, timeout=300, json={
    "model": "bytedance/doubao-seedream-5.0-lite",
    "prompt": "一只戴墨镜的柴犬坐在冲浪板上,黄昏海面,电影感",
    "size": "2K",
})
r.raise_for_status()
# Seedream 默认返回图片地址(约 24 小时后失效),拿到就下载
url = r.json()["data"][0]["url"]
open("out.png", "wb").write(httpx.get(url, timeout=120).content)
import { writeFileSync } from "node:fs";

const BASE = "https://api.lyrouter.com/v1";
const H = { Authorization: `Bearer ${process.env.LYROUTER_KEY}` };

const r = await fetch(`${BASE}/images/generations`, {
  method: "POST",
  headers: { ...H, "Content-Type": "application/json" },
  body: JSON.stringify({
    model: "bytedance/doubao-seedream-5.0-lite",
    prompt: "一只戴墨镜的柴犬坐在冲浪板上",
    size: "2K",
  }),
  signal: AbortSignal.timeout(300_000),
});
const { data } = await r.json();
// Seedream 默认返回图片地址(约 24 小时后失效),拿到就下载
const img = await fetch(data[0].url);
writeFileSync("out.png", Buffer.from(await img.arrayBuffer()));
图像编辑有两种请求体,选哪种取决于模型(支持矩阵见上面「图像生成与编辑」一节):
文件上传形态,五个模型都可用(Gemini 系自 2026-10-09 起也支持)。
r = httpx.post(f"{BASE}/images/edits", headers=H, timeout=300,
    files={"image": open("cat.png", "rb")},
    data={"model": "openai/gpt-image-2",
          "prompt": "把背景换成雪山",
          "quality": "medium"})
图片转 base64 放进请求体。五个模型都可用。
import base64

b64 = base64.b64encode(open("cat.png", "rb").read()).decode()
r = httpx.post(f"{BASE}/images/edits", headers=H, timeout=300, json={
    "model": "google/gemini-3-pro-image",
    "prompt": "把背景换成雪山",
    # 单张传字符串;多张参考图传数组
    "image": f"data:image/png;base64,{b64}",
})
import { readFileSync } from "node:fs";

const b64 = readFileSync("cat.png").toString("base64");
const r = await fetch(`${BASE}/images/edits`, {
  method: "POST",
  headers: { ...H, "Content-Type": "application/json" },
  body: JSON.stringify({
    model: "google/gemini-3-pro-image",
    prompt: "把背景换成雪山",
    image: `data:image/png;base64,${b64}`,
  }),
  signal: AbortSignal.timeout(300_000),
});
import base64, mimetypes

p = "cat.jpg"
mime = mimetypes.guess_type(p)[0] or "image/jpeg"
b64 = base64.b64encode(open(p, "rb").read()).decode()

r = httpx.post(f"{BASE}/chat/completions", headers=H, timeout=120, json={
    "model": "<带「视觉」能力标签的模型>",
    "messages": [{"role": "user", "content": [
        {"type": "text", "text": "这张图里有什么?"},
        {"type": "image_url", "image_url": {"url": f"data:{mime};base64,{b64}"}},
    ]}],
})
print(r.json()["choices"][0]["message"]["content"])
import { readFileSync } from "node:fs";

const b64 = readFileSync("cat.jpg").toString("base64");
const r = await fetch(`${BASE}/chat/completions`, {
  method: "POST",
  headers: { ...H, "Content-Type": "application/json" },
  body: JSON.stringify({
    model: "<带「视觉」能力标签的模型>",
    messages: [{ role: "user", content: [
      { type: "text", text: "这张图里有什么?" },
      { type: "image_url", image_url: { url: `data:image/jpeg;base64,${b64}` } },
    ]}],
  }),
  signal: AbortSignal.timeout(120_000),
});
const j = await r.json();
console.log(j.choices[0].message.content);
import time, httpx

# 1 提交
r = httpx.post(f"{BASE}/videos", headers=H, timeout=120, json={
    "model": "bytedance/doubao-seedance-2.0-mini",
    "prompt": "一只柯基在草地上奔跑,阳光穿过树叶",
    "size": "1280x720",
    "seconds": 5,
})
r.raise_for_status()
task_id = r.json()["id"]

# 2 轮询到终态。10~30 秒一次即可,不要更密。
while True:
    time.sleep(15)
    task = httpx.get(f"{BASE}/videos/{task_id}", headers=H, timeout=60).json()
    print(task["status"])
    if task["status"] in ("completed", "failed"):
        break

if task["status"] == "failed":
    raise SystemExit(task)      # 失败原因在任务对象里

# 3 取产物。默认 302 到产物地址,所以要跟随重定向;
#   产物地址有效期通常 24 小时,拿到就存。
v = httpx.get(f"{BASE}/videos/{task_id}/content", headers=H,
              timeout=600, follow_redirects=True)
open("out.mp4", "wb").write(v.content)
import { writeFileSync } from "node:fs";

const sleep = (ms) => new Promise((r) => setTimeout(r, ms));

// 1 提交
const sub = await fetch(`${BASE}/videos`, {
  method: "POST",
  headers: { ...H, "Content-Type": "application/json" },
  body: JSON.stringify({
    model: "bytedance/doubao-seedance-2.0-mini",
    prompt: "一只柯基在草地上奔跑,阳光穿过树叶",
    size: "1280x720",
    seconds: 5,
  }),
});
const created = await sub.json();
// 提交失败时没有任务 ID,不要继续轮询
if (!sub.ok || !created.id) throw new Error(JSON.stringify(created));
const { id } = created;

// 2 轮询到终态
let task;
for (;;) {
  await sleep(15_000);
  task = await (await fetch(`${BASE}/videos/${id}`, { headers: H })).json();
  console.log(task.status);
  if (task.status === "completed" || task.status === "failed") break;
}
if (task.status === "failed") throw new Error(JSON.stringify(task));

// 3 取产物(fetch 默认跟随重定向)
const v = await fetch(`${BASE}/videos/${id}/content`, { headers: H });
writeFileSync("out.mp4", Buffer.from(await v.arrayBuffer()));
用 OpenAI 官方 SDK
对外契约是 OpenAI 形状,所以官方 SDK 大部分能直接用 —— 把 base_url 指到网关即可:
from openai import OpenAI
client = OpenAI(api_key=KEY, base_url="https://api.lyrouter.com/v1", timeout=300)
| SDK 方法 | 能不能用 |
|---|---|
client.chat.completions.create(...) |
✅ 文本与视觉理解都可以 |
client.images.generate(...) |
✅ 全部图像模型 |
client.images.edit(...) |
✅ 全部图像模型(含 Gemini,2026-10-09 起) |
client.videos.create(...) |
✅ 需要较新版本的 openai Python SDK(实测 1.58.1 没有 client.videos,2.48.0 可用)。SDK 以 multipart 提交,网关会转换成上游需要的格式;URL 形式的 input_reference 要写成 extra_body={"input_reference": url},直接传字符串会在客户端报 RuntimeError: Expected entry at input_reference to be bytes, an io.IOBase instance, PathLike or a tuple…;first_frame、last_frame、reference_image、reference_audio 请用 JSON 提交,写在表单里目前会出错(见「视频通用参数」);查询与下载用上面的 HTTP 写法 |
images.edit()无条件发multipart/form-data。Gemini 的上游只认 JSON,但网关会替你把 multipart 归一并翻译过去,所以现在用它驱动 Gemini 也可以(2026-10-09 起)。此前这条路会失败。
要发网关的扩展参数、或想完全控制请求体时,SDK 自带调任意端点的逃生舱:
import httpx

resp = client.post(
    "/images/edits",
    cast_to=httpx.Response,          # 拿原始响应,不走 SDK 的模型解析
    body={"model": "google/gemini-3-pro-image",
          "prompt": "把背景换成雪山",
          "image": f"data:image/png;base64,{b64}"},
)
img_b64 = resp.json()["data"][0]["b64_json"]
常见错误
返回 400 unsupported_parameters,应该如何处理?
答: 请求启用了 X-Gateway-Strict-Parameters: true,且含有不受支持的参数。按错误信息列出的参数名删除参数,或改用接口契约中的名称。
请求成功,但响应头有 X-Gateway-Unsupported-Parameters,是什么意思?
答: 有参数被丢弃,但请求仍按剩余参数执行。检查这些参数是否必要;需要时改用契约中的名称,不要把请求成功当作全部参数已经生效。
GPT-Image 返回 400 INVALID_REQUEST_BODY,应该检查什么?
答: 检查是否传入 quality。gpt-image-2 必须传 quality(low、medium、high 或 auto),不传会间歇性返回 400。其他 GPT-Image 模型也建议显式传入。结合具体错误核对请求正文。
GPT-Image 提示宽高必须能被 16 整除,怎么办?
答: Invalid size '<宽>x<高>'. Width and height must both be divisible by 16. 表示尺寸不符合约束。将宽和高都设置为 16 的倍数,再按模型支持的尺寸规则调用。
GPT-Image 提示 longest edge、pixel budget 或 Invalid size '4K',怎么办?
答: size 违反了其余几条硬约束:最长边不能超过 3840(Invalid size '<宽>x<高>'. The longest edge must be less than or equal to 3840.),总像素要在约 100 万到约 830 万之间(Invalid size '<宽>x<高>'. Requested resolution is below the current minimum pixel budget. / Invalid size '<宽>x<高>'. Requested resolution exceeds the current pixel budget.),并且只能写 宽x高,不能写档位名(Invalid size '4K'. Expected WIDTHxHEIGHT, for example '1824x1024'.)。对照 GPT-Image 小节的 size 约束表调整尺寸,例如要接近 4K 的 16:9 图写 3840x2160。
GPT-Image 提示 Invalid value: 'xhigh',怎么办?
答: xhigh、max 只有 2.5 系列支持,而且是否可用由上游账号能力决定,可能被拒。改用 high。
Gemini 返回 200,但图片比例或分辨率不是请求的,怎么办?
答: 先看响应头 X-Gateway-Unsupported-Parameters 是否含 size:宽高比与支持比例的偏差超过 2% 时,整个 size(比例和分辨率档)都被丢弃,请求按服务商默认值出图并照常计费。改写成与支持比例精确一致的宽高,例如 16:9 + 4K 写 4096x2304。如果没有被丢弃,再核对档位:gemini-3-pro-image 的 2K 档不生效(输出 token 与 1K 相同);出图尺寸本身也不一定等于请求的宽高,以返回图片的实际宽高为准。生产环境建议带 X-Gateway-Strict-Parameters: true,让被丢弃的 size 直接返回 400。
Seedream 提示 image size must be at least 3686400 pixels,怎么办?
答: 请求低于 Seedream lite 的最小像素约束(3686400,最小正方形是 1920x1920)。使用 2K 档位或更大的宽高,并核对该模型的尺寸规则。
MiniMax 提示短边必须是 480 或 768,怎么办?
答: 模型档位是离散集合。使用档位名(如 768P、2K),或使用短边精确为 480 / 768 的尺寸,并核对所选任务的支持范围。
任务失败并返回 InvalidParameter.TaskTypeConstraint,怎么办?
答: Seedance 的任务类型与参数冲突。对照本页“任务类型与特殊限制”检查参数;编辑任务不要传 seconds,文生视频不要把 omni_reference_task_type 设为 edit 或 extend。
任务失败并返回 InvalidParameter.TaskTypeMismatch,怎么办?
答: 显式声明的 omni_reference_task_type 与模型判定不一致。按本页任务类型表中的关键词写提示词,或改用 auto。
多模态调用出现 504 或客户端超时,应该怎样检查?
答: 先确认客户端是否沿用了文本接口的 30 秒超时。图像请求按分钟级设置等待时间,视频使用异步任务轮询;查询超时不等于任务失败,避免立即重复提交。
产物地址打不开(返回 403 或 404),怎么办?
答: 检查链接是否过期:服务商签发的产物地址通常 24 小时后失效,过期后访问返回 403 或 404。及时下载或转存产物。视频的产物地址在任务完成时写入一次,重新查询任务拿到的仍是同一个地址;链接过期后需要重新提交任务。
多模态错误正文是什么结构?
答: 错误响应使用 OpenAI 形状,读取 error.message、error.type 与 error.code,并结合 HTTP 状态和请求日志定位:
{ "error": { "message": "…", "type": "invalid_request_error", "code": "unsupported_parameters" } }
API 规格与代码生成
多模态接口的完整规格可直接下载,喂给代码生成器就能得到你所用语言的客户端:
这两个文件由控制台提供(就是你正在看这篇文档的站点),不在网关地址上 —— 下面示例里的 <your-console-host> 因此与别处的 api.lyrouter.com 不是同一个域名。
| 文件 | 用途 |
|---|---|
| OpenAPI 规格(YAML) | 机器读;可直接用于 openapi-generator、openapi-typescript 等工具 |
| 接口参考(Markdown) | 人读的完整参考,含每个参数的取值范围与计费口径 |
生成 TypeScript 客户端:
npx openapi-typescript https://<your-console-host>/ai_gateway/api-spec/multimodal-openapi.yaml \
  -o ./src/gateway-api.d.ts
生成 Python 客户端:
openapi-generator-cli generate \
  -i https://<your-console-host>/ai_gateway/api-spec/multimodal-openapi.yaml \
  -g python -o ./gateway-client
对外契约是 OpenAI 形状:产物固定在顶层
data[]数组里,usage固定在顶层。可以直接用 OpenAI 官方 SDK 调用图像接口,创建视频任务也可以用 SDK 的videos.create();查询和下载视频建议用 HTTP 直调。