调用费用与缓存计费
一次文本调用的费用由四类 Token 分别计价后相加:「输入(缓存未命中)」按价格表的「输入」单价,「输入(缓存命中)」「输出」「显式缓存创建」按价格表中同名一项的单价。单价以工作空间 模型广场 中模型详情的「平台价」为准,长上下文分档、分时计价、服务档位等条件会改变适用的单价。只有成功的调用扣费,估算结果可以用请求日志的「费用」和 订阅充值 的「消费明细」核对。
Token 的四个计费项
日志详情「Token 消耗」把一次调用的 Token 分成四项,四项互不重叠:
| 日志中的名称 | 含义 | 价格表中对应的列 |
|---|---|---|
| 输入(缓存未命中) | 本次输入中没有命中上游提示词缓存、需要重新计算的部分 | 「输入」 |
| 输入(缓存命中) | 命中上游提示词缓存的输入 | 「输入(缓存命中)」;没有单独标价时按「输入」 |
| 输出 | 模型生成的 Token,包括思考(推理)过程 | 「输出」 |
| 显式缓存创建 | 通过 cache_control 写入上游缓存的输入,只在 Anthropic 协议的上游出现 |
「显式缓存创建」;没有单独标价时按「输入」 |
- 输入要拆开算:「输入(缓存未命中)」加「输入(缓存命中)」是这次调用的全部输入。OpenAI 兼容响应里的
prompt_tokens通常已经包含缓存命中部分,估算时先减去命中量,再分别乘两种单价,不要把命中部分再按输入单价算一遍。 - 两个合计不同:「Token 消耗」的「总计」是四项之和;日志列表的「总 Token」和详情的「Token 总量」是输入加输出,不含「显式缓存创建」,所以可能比「总计」小。
- 在列表中查看:日志列表默认只显示「总 Token」,可以在「自定义列」中打开「输入(缓存未命中)」「输入(缓存命中)」「输出」和「费用」;「显式缓存创建」只在详情中显示。
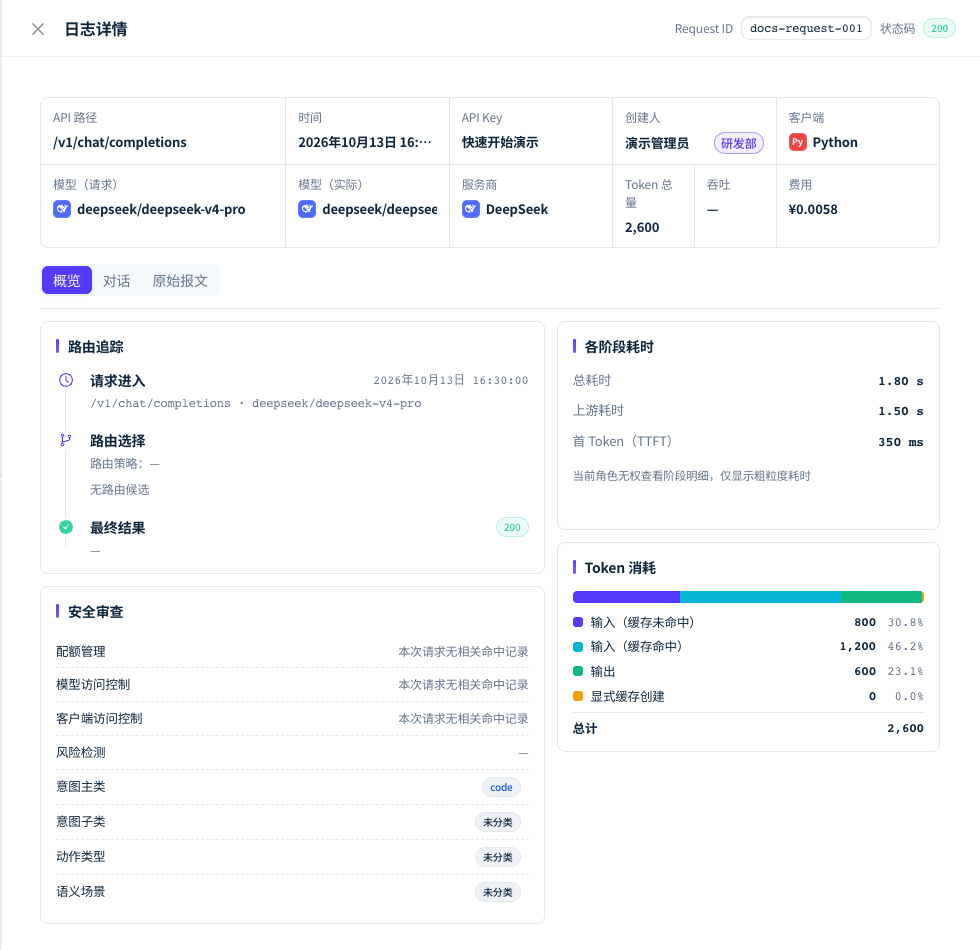
图 1:日志详情的 Token 消耗分四项列出数量和占比,基本信息中的费用是这次调用的实际扣费。 截图为演示数据,点击图片可查看原图。
估算一次调用的费用
- 在工作空间的 模型广场 中打开模型,进入「服务商与价格」,找到要使用的来源。平台通道看「平台价」;「BYOK 参考价」「官方参考价」只供比较,不是平台扣费价。
- 确认价格单位。文本模型通常是「/ 百万 Token」,图片、视频、语音可能按「张」「秒」「分钟」「万字符」「次」计价。
- 按表格的「适用条件」找到这次调用落在哪一行,再按下式计算:
费用 = 输入(缓存未命中) × 输入单价
     + 输入(缓存命中)   × 输入(缓存命中)单价
     + 输出              × 输出单价
     + 显式缓存创建       × 显式缓存创建单价
(按百万 Token 计价时,各项 Token 数先除以 1,000,000)
有权限查看折扣时,价格表会同时显示划线原价和折扣后的价格,按折扣后的价格估算。价格表中的「—」表示暂无报价,不代表免费。
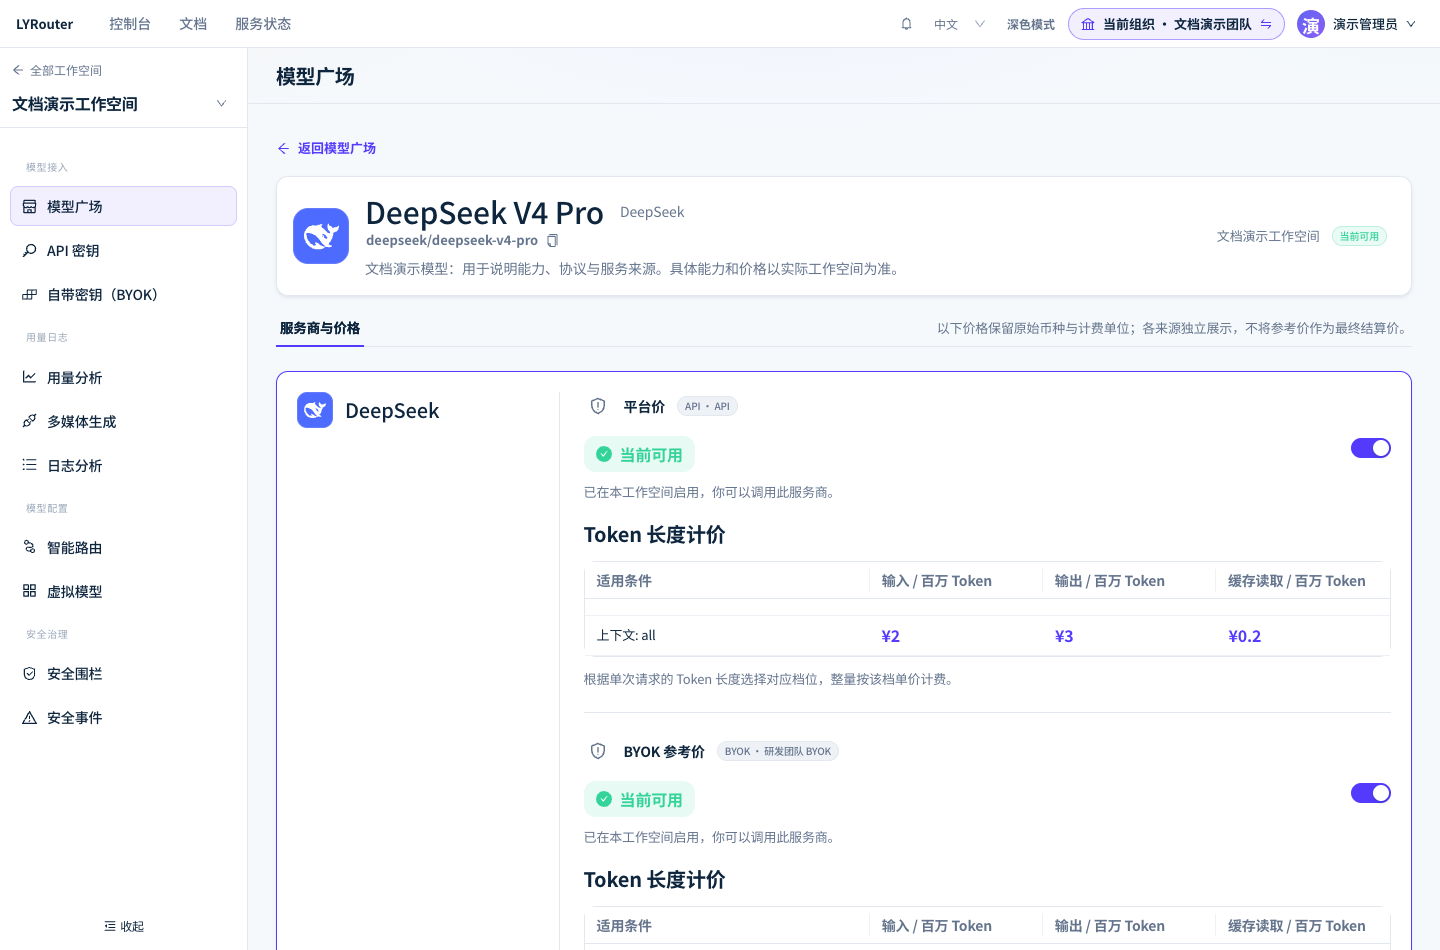
图 2:模型详情的服务商与价格按来源列出平台价、计价方式和适用条件。 截图为演示数据,点击图片可查看原图。
价格表上的计价条件
价格表标题显示计价方式,「适用条件」列显示每行单价的适用范围:
| 计价方式或条件 | 如何影响费用 |
|---|---|
| 固定单价 | 所有调用使用同一组单价 |
| Token 长度计价 | 按单次请求的 Token 长度选档,整次请求都按该档单价计费。判断输入长度时使用全部输入 Token,包括缓存命中的部分,所以缓存命中率再高,长上下文请求也按长上下文档计价 |
| 分时计价 | 按请求发生的星期和时段乘以对应系数。时段含开始、不含结束,按价格表标注的时区判断;只区分星期几,不区分法定节假日和调休 |
| 条件计价 | 按服务档位、模态、分辨率、时长等条件选价。例如「服务档位」按上游实际使用的档位计价,「每次前 N … 免费」表示每次调用先扣除这部分数量再计费 |
| 复杂计价 | 页面提示「存在未完整展示的计价条件,请核对完整定价规则后使用。」,请联系支持确认后再估算 |
哪些调用会扣费
- 只按成功的调用扣费:上游返回错误或连接失败的调用不扣费。网关自动换通道或改用备用模型时,只按最终成功的那一次计费,失败尝试的费用不会转给你,见失败重试与备用模型。
- BYOK 调用:Token 费用由你直接与服务商结算,平台对每次成功调用扣一笔按订阅版本确定的平台服务费,日志「费用」显示的就是这笔服务费,见BYOK 费用与凭证管理。通过 BYOK 接入的 Coding Plan 按服务商套餐计费,不按 Token 单价结算,见API 按量服务与 Coding Plan。
- 异步任务:视频等异步生成在任务完成后结算。创建任务的请求本身不产生费用,日志列表在结算前显示「结算中」,见多模态能力。
显式缓存的计费
在请求里用 cache_control 标记缓存断点、且这次调用由 Anthropic 协议的上游服务时,写入缓存的部分记为「显式缓存创建」,按「显式缓存创建」单价计费;Anthropic 的缓存写入单价高于普通输入。之后几分钟内发送相同前缀的请求,这部分记为「输入(缓存命中)」,按「输入(缓存命中)」单价计费。前缀会被反复使用时,写入的额外费用通常在一两次命中后就能收回。
上游使用 OpenAI 兼容协议时,网关会在发送前删除请求中的 cache_control,这时只有上游自动进行的隐式缓存,不产生「显式缓存创建」。标记规则和提高命中率的方法见降低成本与优化缓存。
用日志和消费明细核对
- 日志「费用」:这次调用实际扣除的 Credits 折算成的人民币金额,在调用时按当时的价格计算并固定下来,之后调价不会改变历史日志的金额。显示「未计算」表示这次调用没有产生扣费,例如调用失败;显示「无权限查看」表示当前账号不能查看这条日志的费用。
- 消费明细:当前账号管理员在 订阅充值 的「消费明细」中按请求查看「消费 Credits」,其中的「请求 ID」与日志详情顶部的 Request ID 相同,可以逐条对应。单次查询的时间范围不能超过 90 天,刚完成的调用可能要几分钟后才出现。
金额对不上时的排查方法见费用异常与缓存未命中,Credits 与订阅的规则见计费规则与信用点。
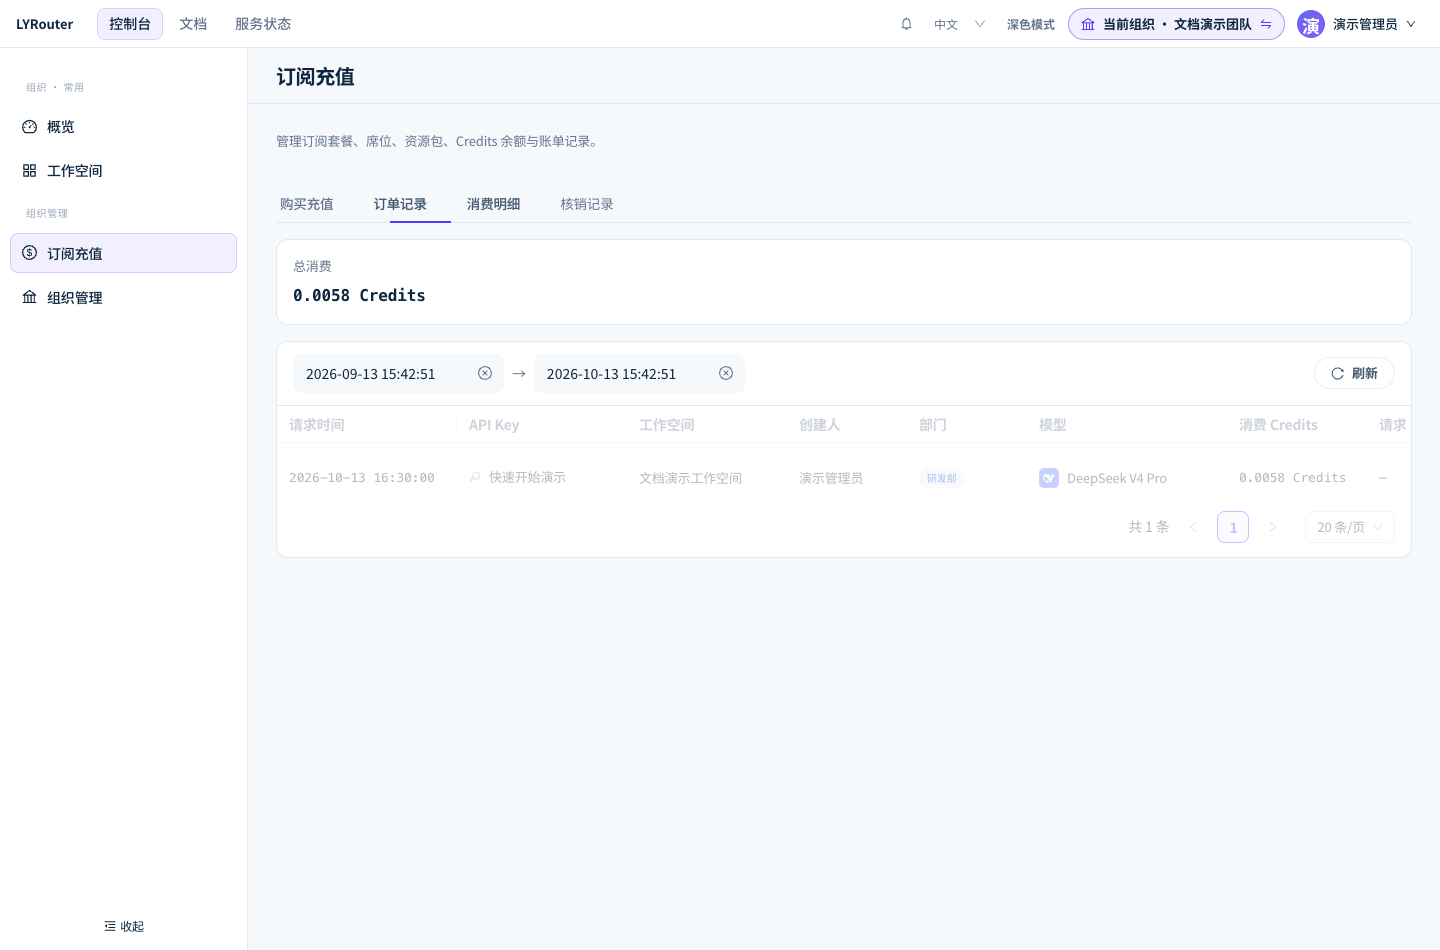
图 3:消费明细按请求列出时间、API Key、工作空间、模型和消费 Credits,可按请求 ID 与日志对应。 截图为演示数据,点击图片可查看原图。