费用异常与缓存未命中
费用与预估不符,最常见的原因是把缓存命中的输入按输入单价重复计算、长上下文请求落入了更贵的档位、思考过程产生了大量输出,或者提示词缓存没有命中。排查时先在请求日志详情的「Token 消耗」中看清四项 Token,再对照下面的问题逐项检查。估算方法见调用费用与缓存计费,提高命中率的做法见降低成本与优化缓存。
先看四项 Token
在 日志分析 中打开这次调用,详情「Token 消耗」列出「输入(缓存未命中)」「输入(缓存命中)」「输出」「显式缓存创建」四项,占比的分母是四项之和。这次调用的缓存命中率按下式计算:
缓存命中率 = 输入(缓存命中) ÷(输入(缓存未命中)+ 输入(缓存命中))
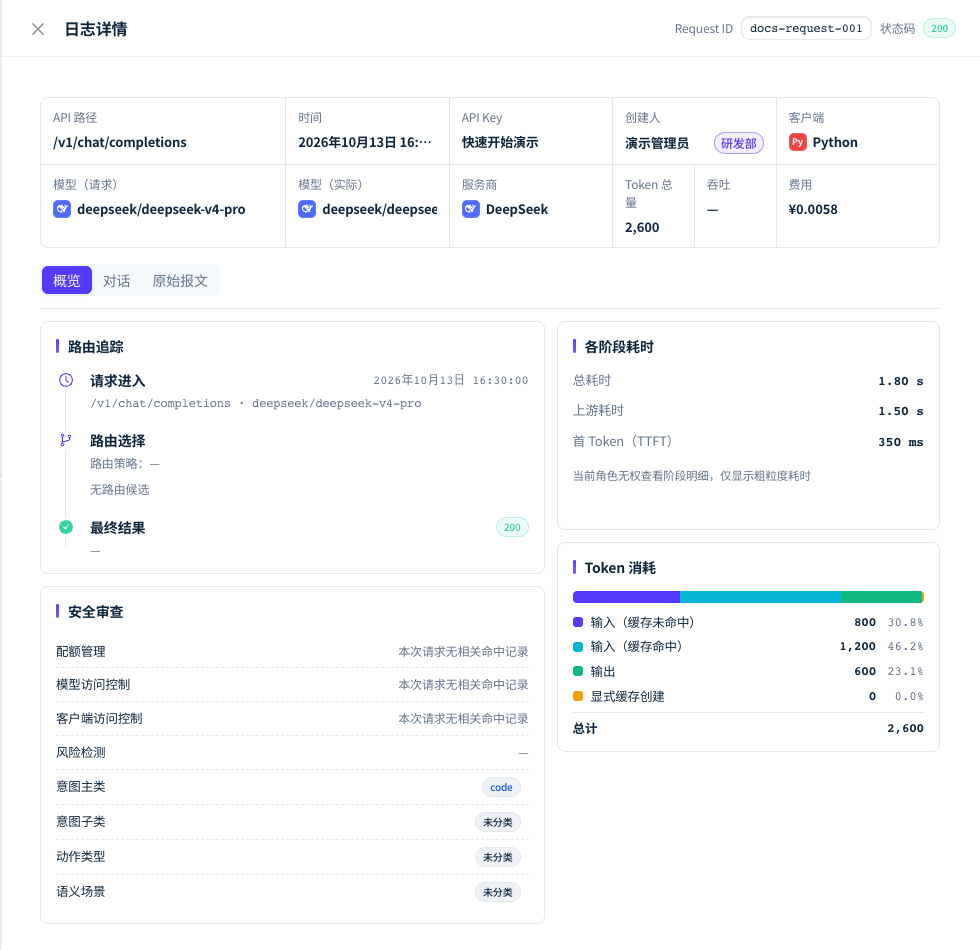
图 1:在 Token 消耗中分别核对缓存未命中输入、缓存命中输入、输出和显式缓存创建。 截图为演示数据,点击图片可查看原图。
费用异常
按输入 Token 自己算出来的费用,为什么和日志不一致?
答: 通常是输入里包含了缓存命中部分。OpenAI 兼容响应的 usage.prompt_tokens 已经包含缓存命中(命中数量通常在 prompt_tokens_details.cached_tokens 中),直接用它乘输入单价会高估;Anthropic 协议响应的 input_tokens 不含缓存读取和缓存写入,它们分别在 cache_read_input_tokens 和 cache_creation_input_tokens 中。由 Claude 等 Anthropic 协议上游服务的 /v1/chat/completions 调用,响应的 prompt_tokens 同样不含缓存命中。核对时以日志的四项为准,按调用费用与缓存计费中的公式分别计价。
缓存命中率很高,为什么仍按长上下文的价格计费?
答: 按 Token 长度分档的模型,用本次全部输入 Token 判断档位,缓存命中的部分也计入长度。一个几十万 Token 的长会话即使大部分命中缓存,也会落在长上下文档,命中部分按该档的「输入(缓存命中)」单价、未命中部分按该档的「输入」单价计费。控制会话长度或定期开启新会话,可以让请求回到较低的档位。
输出 Token 比回答的长度多很多,是什么原因?
答: 思考(推理)过程也计入「输出」。工作空间开启全文日志时,可以在日志详情「对话」页签中看到思考内容及其 Token 数。不需要深度思考的任务,可以在请求中降低思考强度或关闭思考(参数因模型而异),并用 max_tokens 限制输出上限。
没有写 cache_control,为什么出现了「显式缓存创建」?
答: 「显式缓存创建」只在 Anthropic 协议的上游出现,来源有两种:Claude Code 等客户端会自动在请求中标记缓存断点;较早创建、开启了「Anthropic 提示词缓存」的虚拟模型,会在请求没有自带标记时为系统提示词加上标记。写入缓存按「显式缓存创建」单价计费,同一前缀在随后几分钟内被重复使用时,会按「输入(缓存命中)」单价计费,总体通常更省。
日志「费用」显示「未计算」,是没有扣费吗?
答: 通常是。「未计算」表示这条日志记录的扣费金额为 0 或没有记录,最常见于调用失败;个别情况下是这次调用的价格没能算出。要确认是否扣除了 Credits,按 Request ID 到 订阅充值 的「消费明细」中查找:查不到即没有扣费。日志列表的「费用」显示「结算中」时,是异步任务还没有结束,任务完成后显示整个任务的费用。显示「无权限查看」时,是当前账号不能查看这条日志的费用。
日志费用、消费明细和用量分析的金额为什么对不上?
答: 三处的口径不同:
| 位置 | 显示什么 | 单位 |
|---|---|---|
| 日志「费用」 | 单次调用实际扣除的 Credits 折算的金额;BYOK 调用是平台服务费 | 人民币 |
| 订阅充值 的「消费明细」 | 按请求列出实际扣除的 Credits,只列有扣费的请求 | Credits |
| 用量分析 的「费用」视角 | 平台请求按客户实付金额统计;BYOK 请求按服务商成本统计,BYOK 订阅费用单独列为未分摊 | 人民币 |
按 Request ID 可以把日志与消费明细逐条对应。比较汇总金额时,确认时间范围、工作空间和 API Key 相同;刚完成的调用可能需要几分钟才出现在用量分析和消费明细中。BYOK 请求在用量分析中显示的是你付给服务商的费用,不是平台服务费,所以与日志不同。
同样的用量,不同时间的费用为什么不同?
答: 检查价格表是否为「分时计价」:不同星期和时段的系数不同,节假日调休按星期几计算。另外,每次调用按当时生效的价格计费,调价后的新调用使用新价格,历史日志的金额保持不变。
较早的 Claude 日志,「输入(缓存未命中)」为什么偏小或为 0?
答: 较早的 Anthropic 协议日志记录的输入 Token 不含缓存命中部分,控制台再减去命中量后,「输入(缓存未命中)」会偏小甚至为 0,「总 Token」也不含缓存命中。新产生的日志已按全部输入记录,不受影响。比较这类日志时,以「输入(缓存命中)」和「输出」为准。
缓存未命中
相似的请求为什么没有命中缓存?
答: 提示词缓存在上游服务商侧按字节前缀匹配:从请求开头起任何一个字节不同,之后的内容都不会命中,即使后面几十万 Token 完全一样。常见原因有:系统提示词开头带时间戳、请求 ID 或随机值;会话中途增删或调整了工具定义;历史消息被重新拼装或改写;请求换到了另一个通道或模型。缓存只在同一服务商的同一模型内复用,换模型或换服务商都要重新建立。
命中率一直精确为 0,怎么排查?
答: 说明前缀从第一个字节就不同。开启全文日志后,在日志详情的「原始报文」中比较相邻两次请求的「上游请求」开头。使用 Claude Code 时,部分版本会在系统提示词最开头写入一行带 cch= 的标记,且每个请求的值都不同,导致命中率为 0;升级 Claude Code 到最新版本即可。判断标准是这个值在相邻请求之间是否变化,而不是有没有这一行。
每个会话的前一两次调用为什么没有命中?
答: 第一次调用要先把前缀写入上游缓存,之后的调用才能读到;部分上游写入后需要短暂延迟才可读取,紧接着发出的第二次调用(例如工具结果回传)也可能未命中。之后的调用命中率稳定上升属于正常情况。
同一个会话的命中率忽高忽低,是什么原因?
答: 先确认前缀是否在不同位置被改动,再确认请求是否落到了同一个通道。工作空间的「多渠道选路策略」为「最低价」或「负载均衡」时,同一个 API Key 对同一模型的调用会保持在同一通道 30 分钟,每次调用续期;通道返回 429、408、5xx 或连接失败时会改绑到其他通道,新通道需要重新建立缓存。「最低延迟」「最高吞吐」不做会话保持,每次按当时的指标选择通道。同一会话请始终使用同一个 API Key 和同一个模型 ID,详见通道选择与路由策略。
「显式缓存创建」始终为 0,cache_control 没有生效吗?
答: 只有由 Anthropic 协议上游服务的调用才会使用 cache_control;上游是 OpenAI 兼容协议时,网关会删除这些标记,改由上游的隐式缓存工作。如果确实由 Anthropic 协议上游服务,检查被标记的前缀是否达到模型的最小可缓存长度,以及标记是否打在文本块上——通过 /v1/messages 调用时,打在图片块或 tool_result 块本身上的标记不会转发给上游。
隔了一段时间后第一次调用没有命中,是缓存过期了吗?
答: 不一定。缓存保留多长时间由上游服务商决定,通常为几分钟;有的上游有多个后端,请求没有落到保存缓存的后端时也会未命中。判断是否过期,请看之后连续几次调用的命中情况,不要只看一次。
提交问题时提供的信息
请记录调用时间、模型、API Key 名称,以及日志详情顶部的 Request ID,附上「Token 消耗」四项的数值和日志「费用」。涉及消费明细的问题,再附上对应的「请求 ID」和「消费 Credits」。
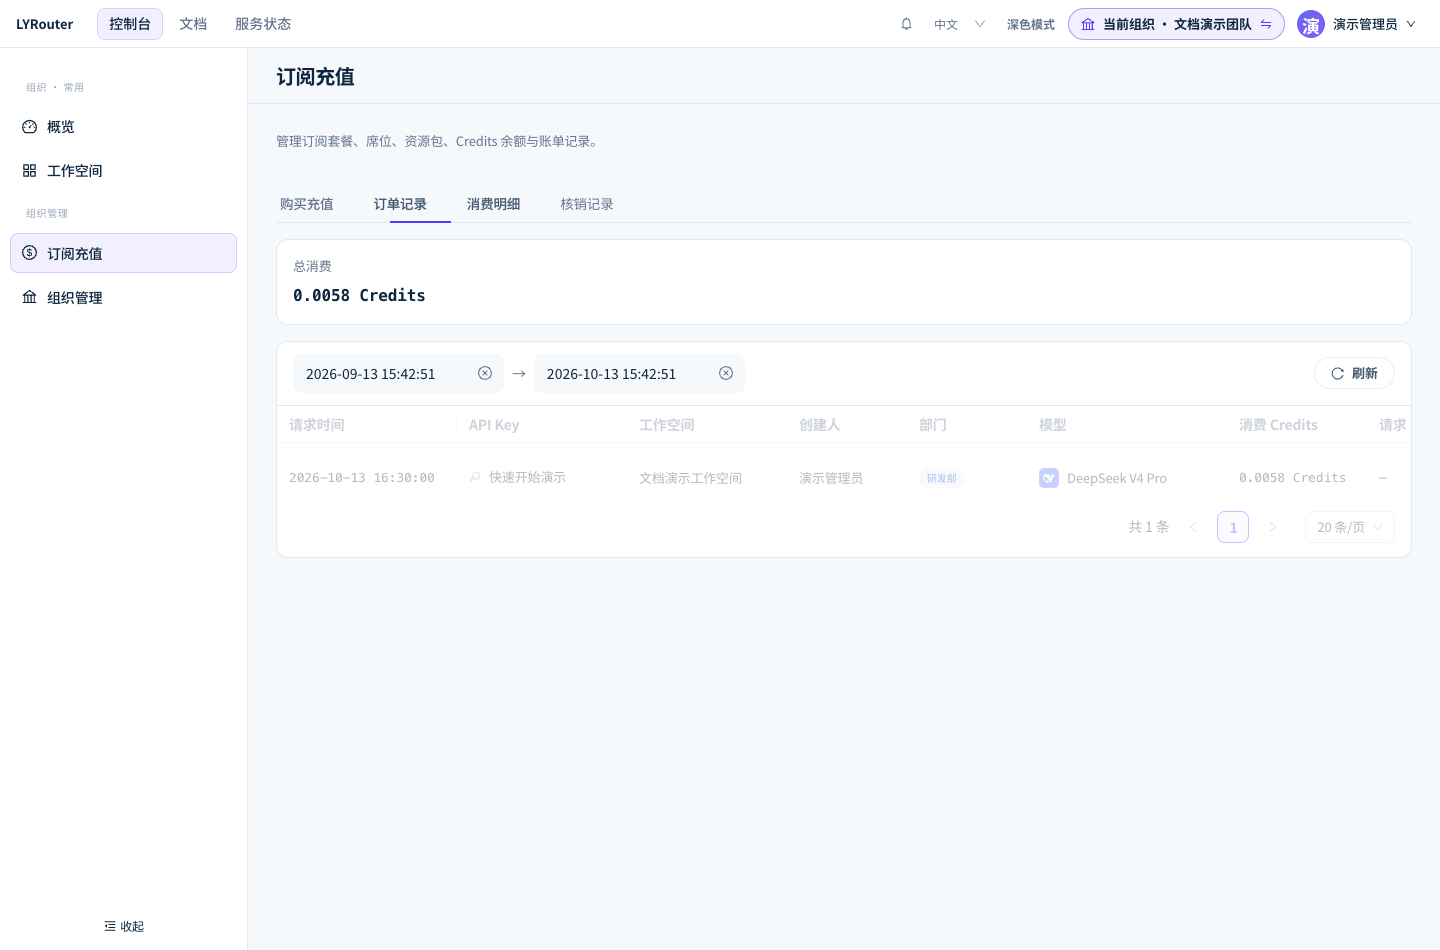
图 2:将请求记录与消费明细按时间、模型和 API Key 对齐核对。 截图为演示数据,点击图片可查看原图。